Unsloth 开源决策模型训练教程:4GB 显存微调 Qwen3.5,准确率如何从 20.7% 提升至 74.3%
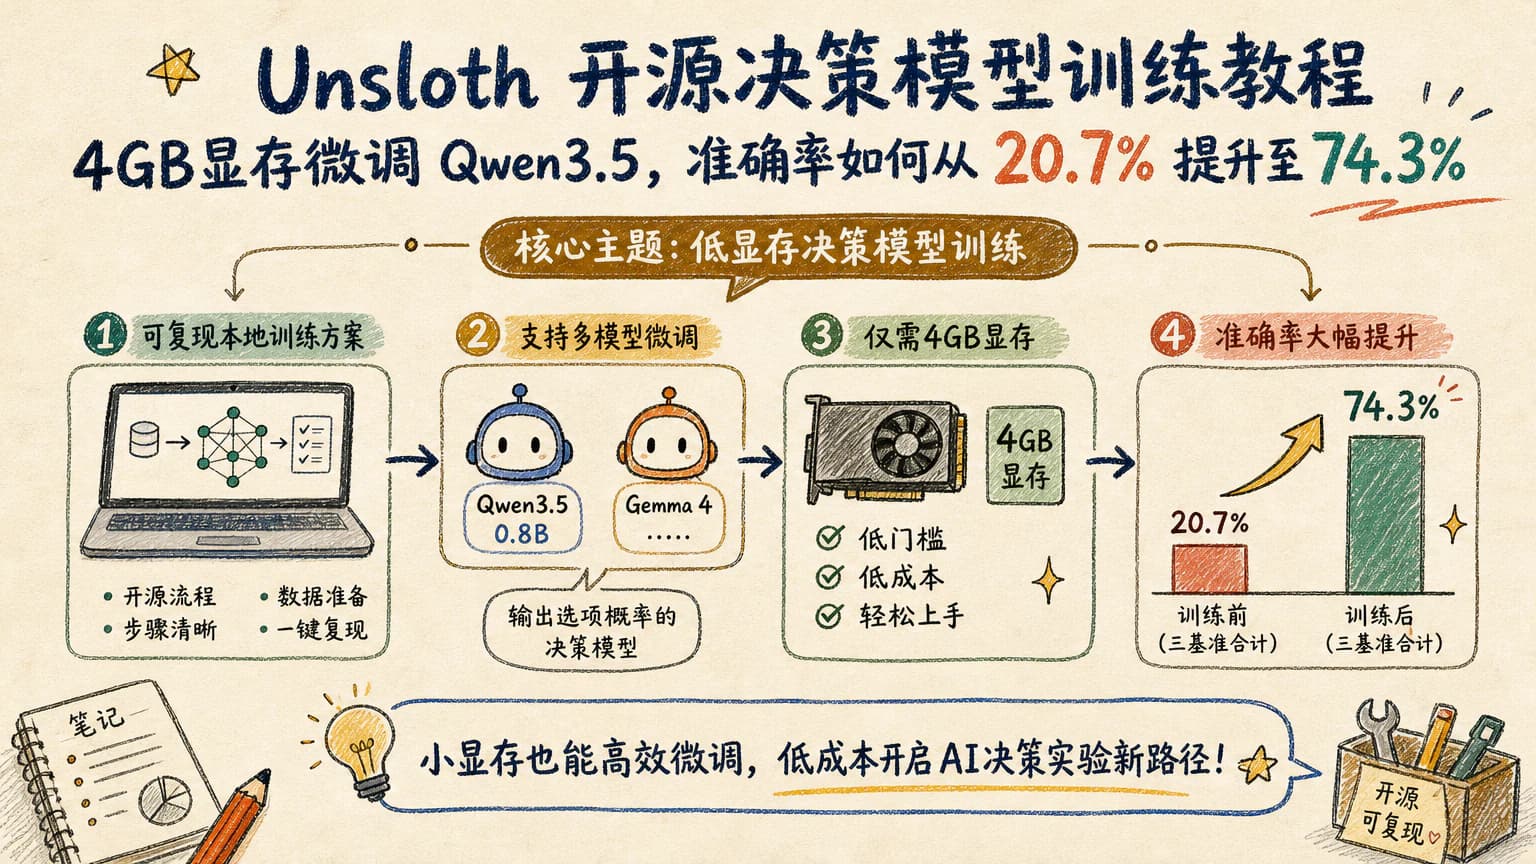
Unsloth 发布可复现的本地训练方案,把 Qwen3.5、Gemma 4 等语言模型微调为输出选项概率的决策模型。教程称,Qwen3.5 0.8B 在三个决策基准上的合计准确率由 20.7% 提升至 74.3%,仅需 4GB 显存,为低成本 AI 实验提供了新路径。
事件概述:小模型也能学习做决策
Unsloth 在社交平台发布了一套开源教程及配套仓库,核心目标是把 Qwen3.5、Gemma 4 等语言模型微调成“决策模型”。这类模型不只生成文字,而是针对一组候选选项给出概率,再由系统选择其中一项,因此更接近分类、排序和行动建议等实际任务。
按照 Unsloth 提供的结果,Qwen3.5 0.8B 在三个决策基准上的合计准确率从
20.7% 提高到
74.3%,整个训练过程仅需约 4GB 显存。这个提升属于教程报告的实验结果,不能直接等同于所有模型、数据和硬件环境都能获得同等表现。
这项教程的意义,不只是把一个参数规模较小的模型训练得更聪明,而是验证了低成本设备也能完成从文本生成到结构化决策的转变。对希望尝试模型微调的个人开发者而言,门槛明显更接近一台常见的工作站或带有独立显卡的电脑。
核心方法:让模型输出可比较的概率
传统指令微调往往让模型直接回答“选 A”或“选 B”,但真实产品更需要知道每个选项的相对可能性。Unsloth 的思路是构造决策训练样本,让模型输出候选选项的概率,再依据这些概率完成任务,从而减少自由生成带来的模糊结果。
这种方法与常见的文本生成应用有明显区别。聊天机器人关注语言是否自然、回答是否完整;决策模型则更强调候选之间的区分度和最终选择是否稳定。一个模型即使能写出漂亮解释,如果每次都在不同选项之间摇摆,也很难用于批量处理或自动化流程。
教程所涉及的开源仓库还降低了实验复现的门槛。开发者可以围绕模型结构、训练数据、评测基准和推理流程进行调整,而不必完全依赖闭源平台的训练界面。对于中文用户来说,真正需要另行准备的是合适的中文任务数据,以及对选项设计和概率含义的理解。
性能提升需要放回评测环境中看
- 7% 到 74.3% 的变化很醒目,但它首先是一个特定实验中的结果。决策任务通常包含多个候选、明确标签和固定评测规则,模型经过针对性训练后,在这些任务上的得分自然会明显变化。不同基准之间也不能简单相加后直接推断通用能力。
对开发者而言,最值得借鉴的是“训练目标要与使用目标一致”。如果产品最终要从十个标签中选择一个,就应该让模型学习可比较的选项概率;如果最终要生成一段面向用户的解释,则还需要另行处理自然语言输出、事实依据和失败兜底,不能只盯着分类准确率。
此外,低显存并不代表低难度。4GB 显存只是资源门槛的一部分,数据清洗、训练轮数、序列长度、模型加载方式和推理速度都会影响实际体验。教程能够证明方案具备实验可行性,但部署前仍应使用自己的数据进行独立测试。
对开发者、创作者和企业的实际影响
对开发者,这提供了一条从零开始构建小型决策系统的路线。可以先从客服意图识别、工单分类、文本路由、内容标签和候选排序等任务入手,再观察模型是否真的比关键词规则或现成分类器更稳定。
对创作者,概率输出可以成为工作流中的一个环节。例如在选题整理、素材归类或多方案初筛中,让模型先给出结构化排序,再由人进行判断。这样可以把计算资源集中在比较、归纳和复核上,而不是让模型直接替代最终决策。
对企业用户,最关键的问题不是“能不能微调”,而是“微调后是否更便宜、更稳定、更容易解释”。如果一个小模型能在内部数据上稳定完成大量重复判断,且错误成本可控,它可能比频繁调用更大的通用模型更适合承担基础任务。
中文用户应该关注什么
中文应用首先需要解决数据和语言适配。公开教程中的实验设置不能自动覆盖中文表达、行业术语和多轮对话,建议先准备一批带有清晰正确答案的中文样本,并按照真实使用场景划分训练集与测试集,避免只测熟题。
其次要关注概率的可解释性。一个模型给出 0.62 与 0.38,和只回答“方案 A”相比更容易接入后续系统,但也需要明确概率如何计算、不同类别是否平衡,以及低置信度时是否应转交人工处理。
最后还要评估速度、维护成本和部署方式。4GB 显存有助于本地实验,但企业生产环境可能更看重并发、延迟、持续运行和故障恢复。中文用户可以把这套教程视为低成本起点,而不是无需验证即可上线的成品方案。
后续观察点:从小模型实验走向可用工具
接下来可以观察 Unsloth 是否继续完善训练脚本、中文资料和更多模型适配,以及是否公开更完整的评测细节。若社区能够复现相近结果,并补充不同任务上的比较,这套方法才更可能从教程变成可复用工具。
产品层面也值得跟踪本地训练、量化部署和轻量推理工具的进展。它们会直接影响普通用户能否在个人电脑上完成数据准备、训练、测试和迁移。对国内 AI 工具使用者而言,未来更现实的竞争焦点可能是工作流是否顺手,而不是单次演示的准确率有多高。
总体来看,Unsloth 这次开源的价值在于把决策模型训练拆成了可理解、可尝试的步骤。它未必立刻替代更大的模型,但确实让低成本、本地化和结构化输出更值得被认真测试。
同主题阅读路径
查看「模型发布」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具