Perplexity 开源多模态嵌入模型:9B 建索引、0.6B 做端侧查询
Perplexity 发布并开源 pplx-embed-v2-late,以 9B 和 0.6B 两档模型处理文本与图像检索,为开发者和中文 AI 工具用户带来新的多模态搜索方案。
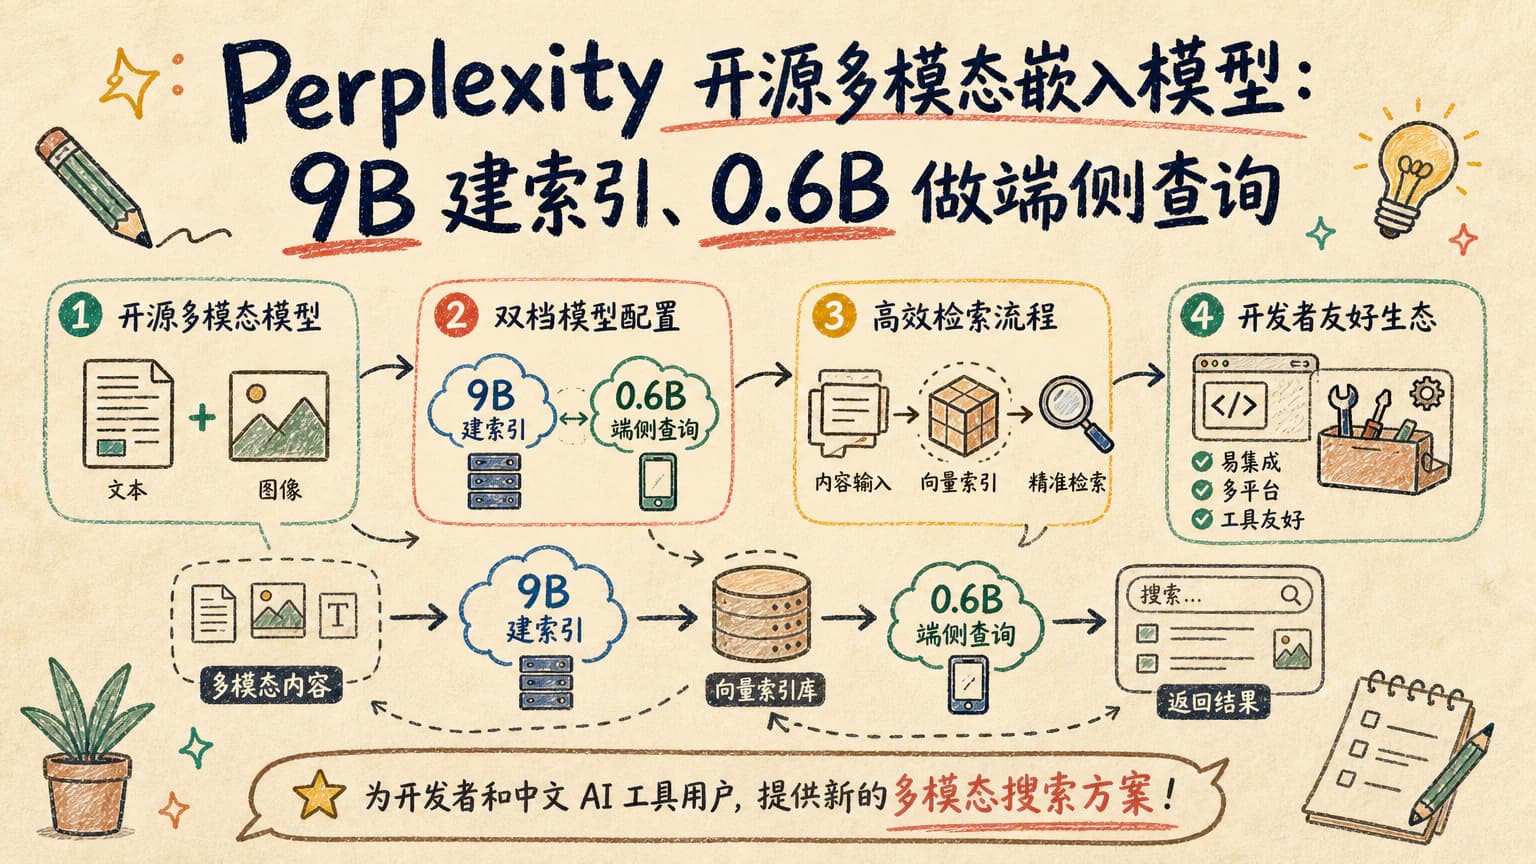
Perplexity 首席执行官 Aravind Srinivas 在 X 上披露,团队开源了 pplx-embed-v2-late 系列多模态嵌入模型。模型不是单一尺寸,而是提供 9B 与 0.6B 两种配置,权重已放到 Hugging Face,供开发者下载和研究。
这次开源了什么
这是一组面向文本和图像的 late-interaction 多向量嵌入模型,也就是把内容转换成多个向量表示,用于后续检索与匹配。9B 版本侧重索引多模态数据,0.6B 版本则面向设备端查询,两种模型共享同一嵌入空间。
多模态搜索的关键,不只是让系统“看见”图片或扫描文件,而是把文字、页面、图表等信息放进可以比较的表示空间。Perplexity 给出的 MADQA 得分为 92.4%,BrowseComp+ 得分为 64%,这些数据属于来源披露的模型评估结果。
两种尺寸为何分开
9B 版本适合离线和服务器端处理更大的内容集合,承担建库、索引等计算量较大的工作;0.6B 版本体积更小,可用于设备端查询。这样的组合让开发者在索引质量与运行效率之间进行分工,而不是让同一模型包办全部环节。
来源还提到,0.6B 模型可在设备端查询 PDF 页面,并且无需 OCR 即可检索。这里的重点是直接理解页面视觉内容,减少先转文字、再做搜索的传统链路。不过,实际效果仍取决于文档类型、硬件性能和查询方式。
对开发者和企业意味着什么
对于开发者,这套模型可以用于本地知识库检索、企业文档搜索、图片与文字混合查询,以及面向 PDF 的问答系统。若能在中文资料上保持稳定表现,它有机会降低多模态检索对额外 OCR 服务和复杂预处理流程的依赖。
对创作者而言,模型带来的直接机会不是自动生成更多内容,而是让作品、资料和视觉素材更容易被组织起来。比如,摄影作品说明、产品页面和参考图可以被放进同一套检索空间,减少手工打标签和反复描述的成本。
真正的价值在于把多模态检索前移到更轻量的设备端。 对企业用户来说,这意味着可以先在本地完成部分查询,再把复杂请求交给服务器,形成分层处理;但部署前仍需验证中文、扫描件和复杂版式下的表现。
中文用户该关注什么
中文用户不应只根据榜单分数判断模型是否适合自己。嵌入模型要放进真实资料里测试,例如中文合同、产品手册、扫描 PDF、网页截图和图文混合文档,观察召回是否准确,以及结果能否被下游模型正确使用。
还需要区分“模型开源”和“应用成熟”两件事。权重公开,方便研究、复现和二次开发,但数据处理流程、向量数据库、权限管理和调用成本仍然要由使用方自行搭建。对于个人用户,端侧运行能否节省费用,取决于设备内存、速度和索引规模。
后续观察点
接下来值得观察三个方向:中文和多语言评测是否充分,PDF 页面检索在复杂表格与手写内容上的稳定性,以及 0.6B 版本在常见手机和电脑上的实际延迟。若这些环节能够落地,多模态搜索可能从云端演示进一步变成日常工具。
在应用层,Perplexity 是否会把模型接入其搜索产品、开放更完整的 API,以及社区是否会出现面向中文资料的微调版本,也是重要信号。当前信息更像是技术底座的公开,而不是某款终端产品已经完成升级。
同主题阅读路径
查看「模型发布」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具