Soup v0.72.4 发布:4GB 显存笔记本也能微调 8B 大模型
Soup 最新版本把 8B 模型微调压到了 4GB 显存的笔记本上,无需云服务或 SSH。个人开发者和内容创作者可以用自己的笔记本做本地大模型定制,硬件门槛和隐私顾虑同时被降低。
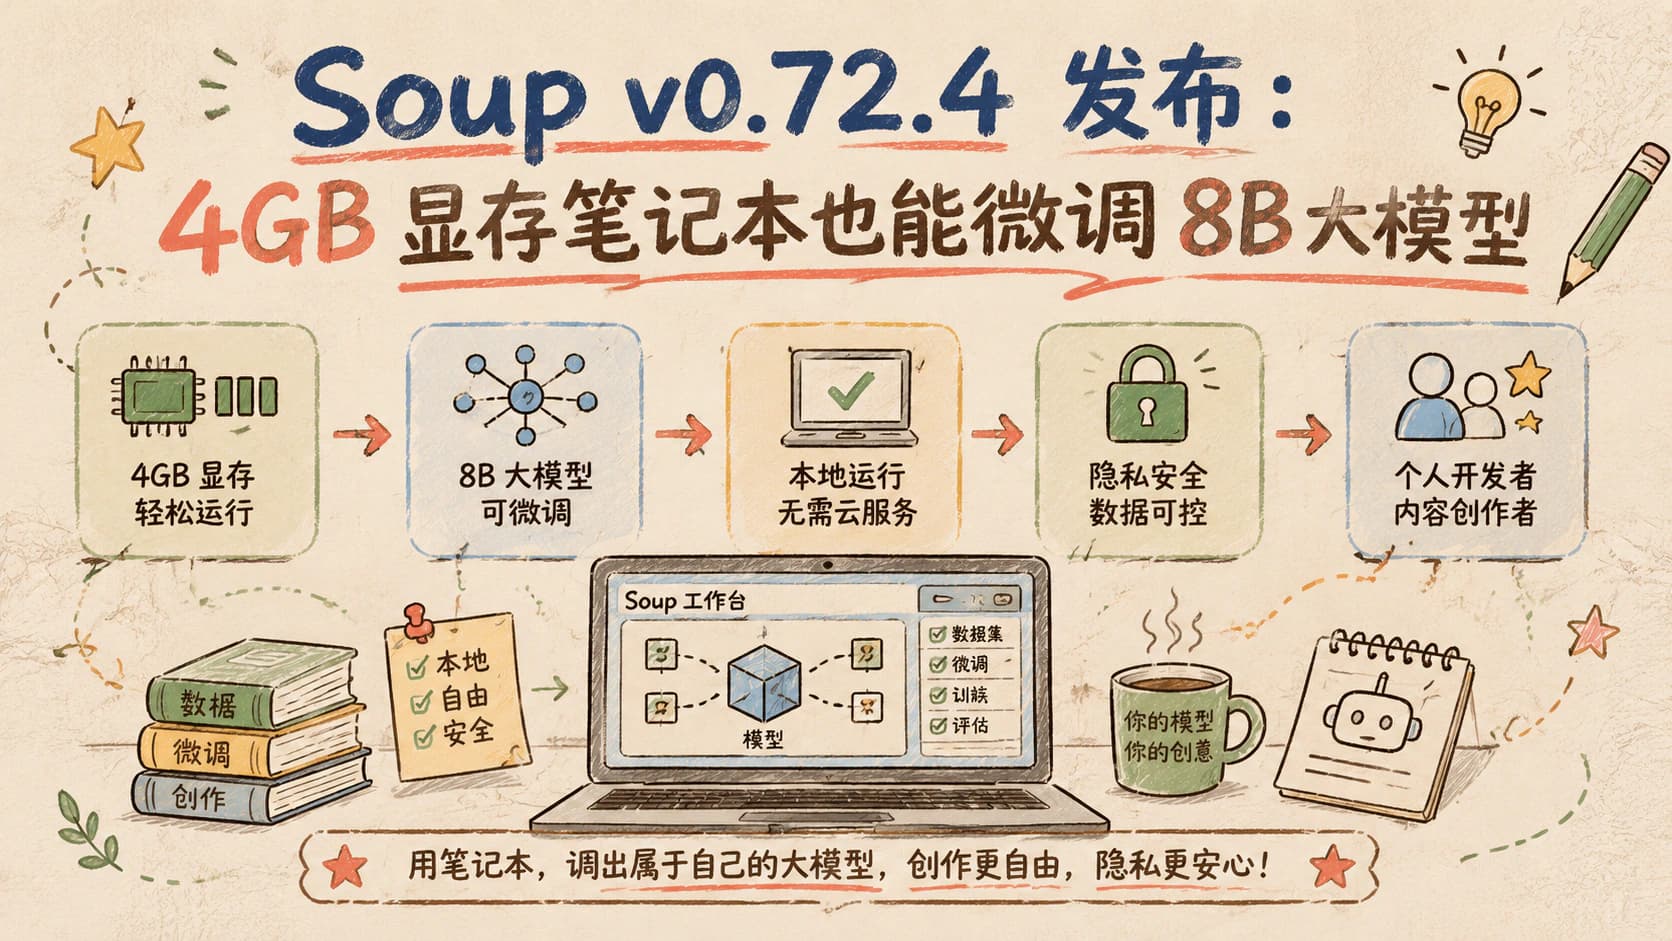
Soup 是一个面向本地微调场景的开源工具,近日更新到 v0.72.4。最直接的卖点写在了 changelog 里:在 4GB 显存的笔记本 GPU 上,就能通过 QLoRA 微调 8B 级别的模型,全程不需要 SSH 远程,也不用租云服务器。
技术亮点:QLoRA 把显存压到消费级
QLoRA 并非新概念,它通过 4-bit 量化和低秩适配,把原本需要几十 GB 显存才能跑起来的微调任务,压缩到消费级显卡的范围内。Soup 的新版本把这条链路再向下做了一步,把目标卡从 8GB、12GB 拉到 4GB 这一底线。
这意味着什么?过去 8B 模型的微调基本是云端或工作站的活儿,个人开发者要么花钱买 A100/H100 算力,要么在 Colab、Kaggle 这类托管平台上排队。现在一台带入门独显的游戏本,理论上就能完成一次端到端的 LoRA 训练。
谁会用上、谁要谨慎
最直接的三类人是:本地 LLM 玩家、没有 GPU 预算的学生和独立研究者,以及想做领域微调但不想把数据送上云的小团队。对他们来说,不离开本地既是成本问题,也是隐私问题。
需要注意的是,4GB 显存只是训练 LoRA 适配器的门槛,不是万能钥匙。上下文长度、batch size、是否做全参数微调,都会迅速吃掉显存余量。Soup 强调开箱即用,但实际学习率、量化方式还是要自己调。
中文场景的本地价值
和云端方案相比,本地微调的优势在于数据不外传、硬件一次性投入;劣势是调试周期长、模型规模受显卡限制。云端工具链(HF、AWS、阿里云 PAI 等)成熟稳定,但中小团队往往要算账。
对中文场景来说,本地微调的价值更明显——很多企业或个人的语料并不想上传第三方平台。Soup 这种轻量工具让用 4090、4060 笔记本跑一个行业小模型成为可能,但离真正替代云端训练还有距离。
后续值得观察
如果打算上手,建议先确认三件事:显卡型号是否在 Soup 兼容列表里、PyTorch 与 CUDA 版本是否匹配、训练数据有没有做脱敏处理。项目在 GitHub 开源,issue 区是观察实际可用性的最快窗口。
从更大的视角看,Soup 走的是把大模型本地化推到极致的路线。和 Ollama、LM Studio、llama.cpp 一样,它在押注一个趋势:未来不是所有人都要在云上跑模型,而是有人会反过来,把模型搬回自己的机器上。
同主题阅读路径
查看「模型发布」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具