Qwen3.8-Max 把 Max 级权重开源了:2.4T 参数的 MoE 模型下周可下载
Qwen 正式发布 Qwen3.8-Max,总参数 2.4T、激活 95B,首次将 Max 级权重开源。这是国内大模型在 2025 年最关键的一次开放动作,直接影响中文社区的模型选型、推理成本和企业部署策略。
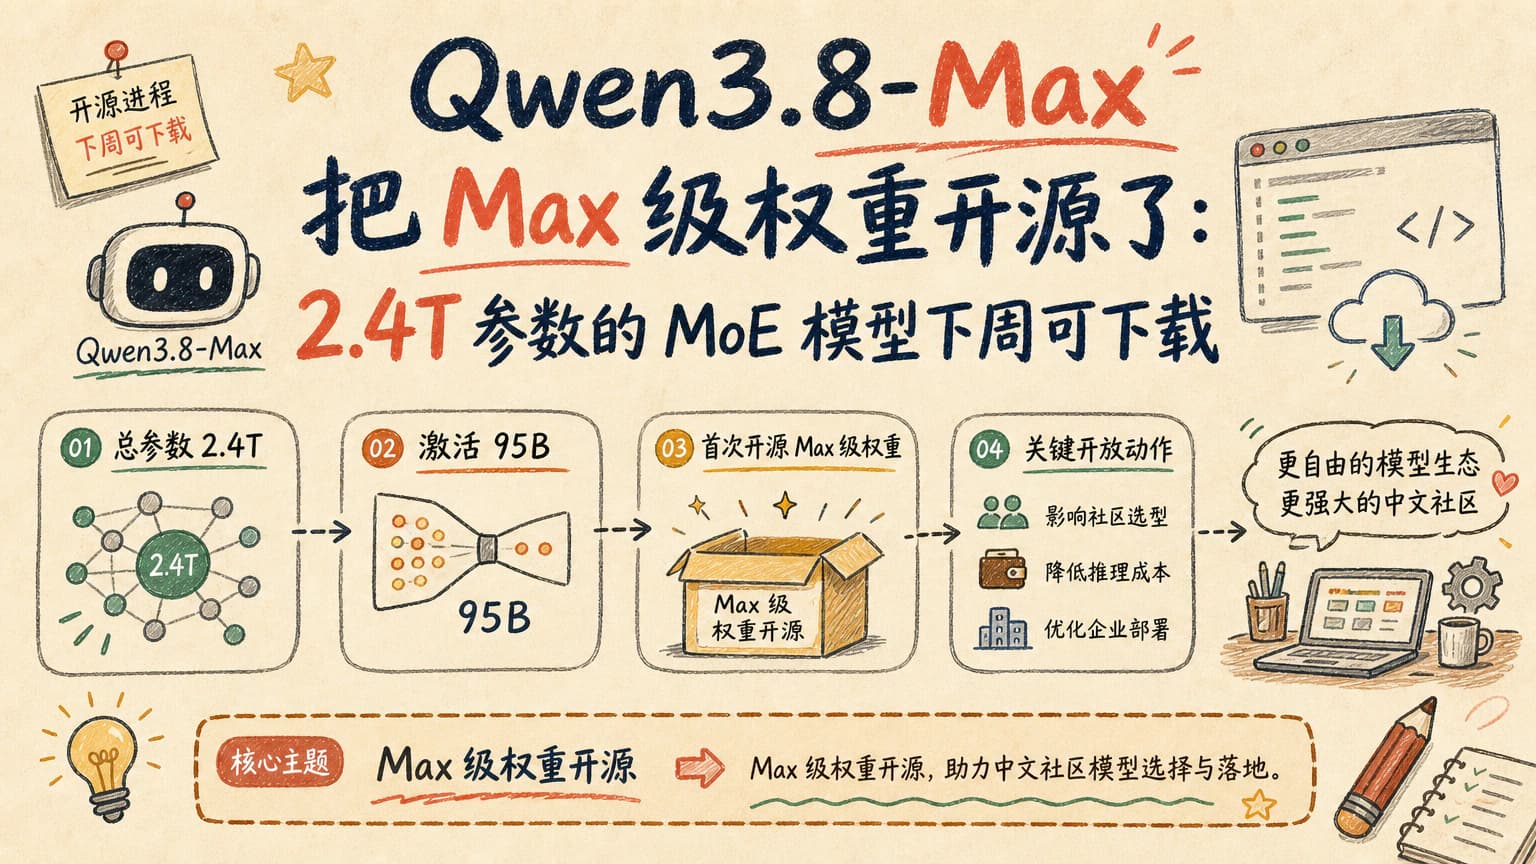
通义千问近期正式发布 Qwen3.8-Max,这是 Qwen 家族迄今定位最强的版本。从更新节奏看,这不是一次普通迭代——团队首次把 Max 级别的模型权重推向了开源社区。
核心看点:2.4T 参数与 MoE 路线
先看最直观的数字:Qwen3.8-Max 总参数 2.4 万亿,单次推理激活约 95B。路线很明显是 MoE——模型体量拉得很大,但每次真正"用脑"的部分控制在了百亿级。激活参数规模才是推理成本和显存压力的真正决定因素,这个数字对部署而言比较友好。
官方给出的定位是"开源最强编码与协作模型"。编码能力是这两年大模型竞争最激烈的方向之一,从国际同行到国内的 DeepSeek、智谱、Kimi 等,多家都在反复拉锯。Qwen3.8-Max 把 Max 级别开放,意味着这一档的能力不再只锁在 API 里。
首次开源 Max 级权重,释放了什么信号
Qwen 家族此前开源过的版本大致停留在 Qwen3 系列的中高位段,Max 级长期作为闭源 API 提供。这次下放权重,团队对模型安全性与商用风险的判断显然更自信了。开源节奏的提速,往往比模型本身更能说明一家公司的战略方向。
对中文用户来说,最直接的变化是:以前要调用 Qwen-Max 级别能力,必须走 API 并付费;权重开放后,本地推理、私有化部署、垂直领域微调都有了新的底座。这对国内做 Agent、做企业知识库、做垂直应用的团队,是相当直接的利好。
对开发者和企业的实际影响
企业最关心的不是榜单分数,而是能不能用、好不好管。2.4T 总参数意味着完整部署对硬件要求很高,但 95B 的激活规模让单次推理的成本相对可控。中小团队真正"用上",还得等社区产出量化版、蒸馏版,或者等云厂商跟进托管服务。
对个人开发者和小型团队来说,比较现实的路径是先关注 LoRA 微调方案和量化部署教程。Qwen 社区的工程化积累一直不错,从 Qwen2.5 到 Qwen3,第三方微调和部署文档积累得很厚。这波开源大概率会带动一轮新的"私有化大模型"落地潮。
如果是内容创作者或产品经理,可以重点关注它在长上下文、代码理解、多轮协作上的实测表现。"协作"二字在官方语境里通常对应多文件项目、Agent 任务这类复杂场景,这和单纯刷榜不是一回事。
后续值得观察的几件事
把视野拉远一点,Qwen3.8-Max 的发布和近半年整个开源大模型的节奏是合拍的。头部模型不再把最强版本锁死在 API 里,已经是一个明显的趋势。
下周权重正式开放后,几个细节值得盯着:许可证的具体条款(是否允许商用)、上下文窗口与多模态能力是否同步、社区的首批复现报告和实测反馈。Qwen 每次大版本更新,国内开源生态都会跟进一批,这次大概率也不例外。
同主题阅读路径
查看「模型发布」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具