Agent Lightning v1.0 如何用真实执行框架训练 AI 智能体?
Microsoft Research Asia 开源约 3,500 行的 Agent Lightning v1.0,核心思路是让部署时使用的同一套智能体执行框架直接参与强化学习,减少训练与实际运行之间的代码重写成本。
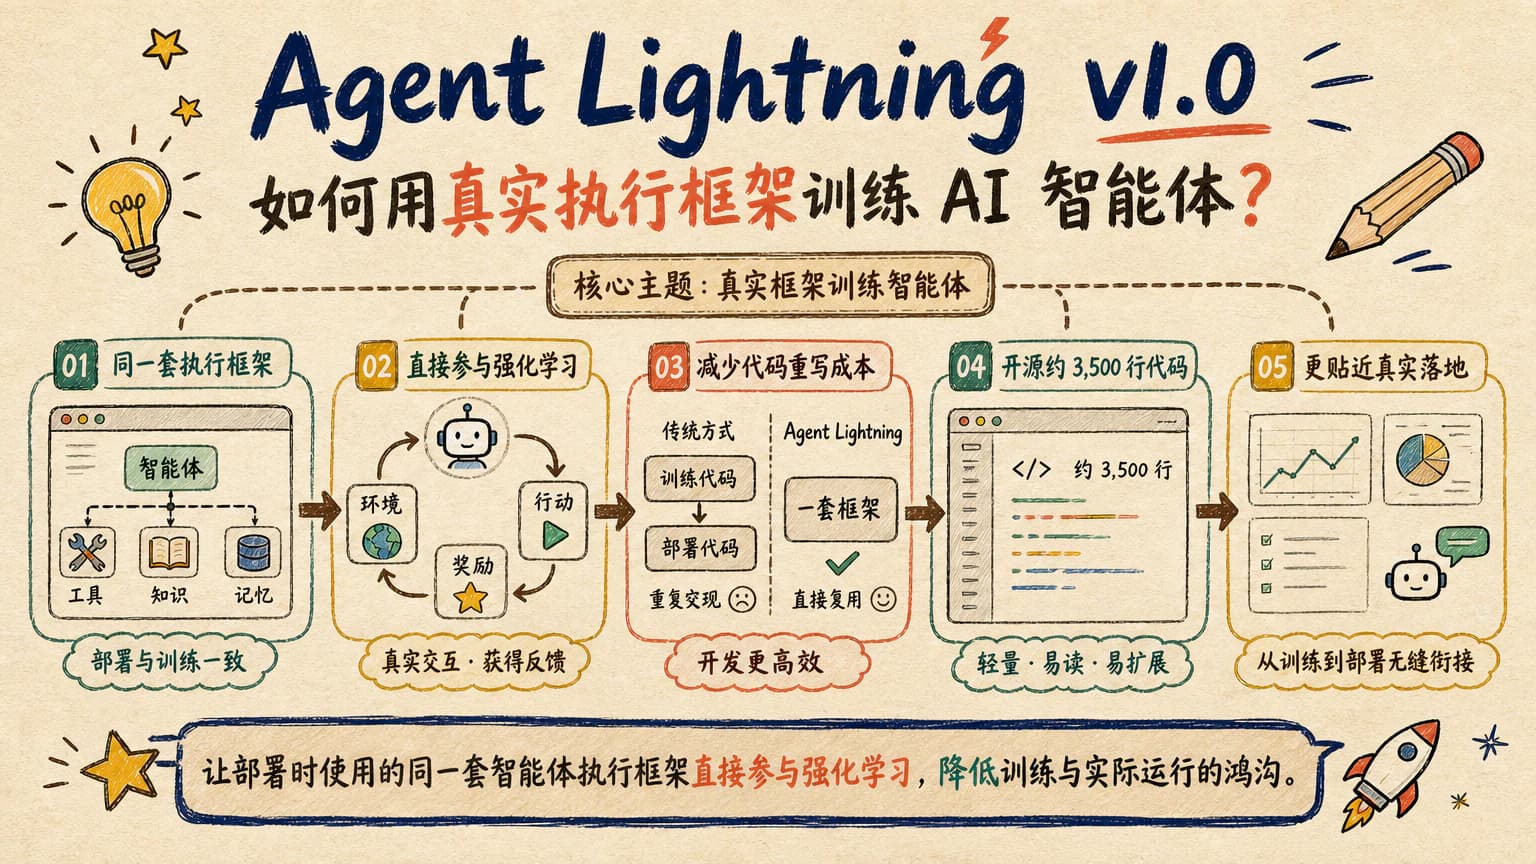
Microsoft Research Asia 提出 Harnessed Agentic RL 训练范式,并开源重建后的 Agent Lightning v1.0。它瞄准的是智能体开发中一个常见问题:训练阶段使用一套框架,部署时又换回业务执行环境,导致同一套工具调用、规则和流程需要反复适配。
这套框架的关键并不只是接入强化学习,而是把真实执行环境中的 agent harness 直接用于训练。简单说,harness 是负责模型推理、工具调用、上下文组织和流程推进的执行框架;Agent Lightning 希望训练与部署围绕同一套执行基础展开。
约 3,500 行代码解决什么问题
此次开源版本的代码规模约为 3,500 行,定位是轻量级智能体强化学习框架。其主要变化,是开发者不必在训练框架内部重新实现已经用于部署的智能体执行逻辑,而可以让现有 harness 参与训练过程。
传统做法往往先把智能体封装成训练接口,再把任务改写成强化学习环境。Agent Lightning 试图保留真实工具调用和执行反馈,让训练信号更接近智能体上线后的实际表现,也减少因两套代码行为不一致而产生的偏差。
这种设计尤其适合已经拥有成熟智能体系统的团队。比如,智能体可能已经连接搜索、数据库、企业知识库或内部工作流。如果每次优化模型都要重写这些调用逻辑,维护成本会随着工具数量增加而迅速上升。
对开发者和企业用户的影响
对开发者而言,最直接的变化是训练流程与现有工程结构的距离缩短。原本写在业务仓库中的执行框架可以被纳入训练链路,团队不必为了训练而复制一份“专用版”智能体,也不必长期维护训练代码与线上代码之间的映射层。
对创作者和小团队来说,这也让小规模强化学习实验更容易贴近真实任务。一个内容生成智能体如果需要调用网页检索、素材分析或发布前检查工具,训练阶段就可以基于相同流程获得反馈,而不是只对孤立的模型输出进行打分。
对企业用户而言,价值更多体现在系统维护方式上。训练环境和生产环境共享执行框架后,工具接口、业务规则或上下文组织方式发生变化时,需要同步修改的地方可能更少。不过,这并不代表可以跳过模型评测、安全测试和上线验证。
真正的重点是执行一致性,而不是把强化学习门槛降到最低。 接入真实 harness 意味着训练过程更接近业务现场,也可能同时暴露接口延迟、工具失败、上下文膨胀和成本控制等问题,需要先把执行环境与训练任务隔离清楚。
中文用户接下来应该关注什么
中文用户首先要判断自己的智能体是否具备稳定、可重复的 harness。如果工具调用仍散落在多个脚本中,流程没有统一入口,那么直接采用 Agent Lightning 的收益可能有限;先把执行逻辑整理成清晰边界,通常比更换训练框架更重要。
其次应关注框架与现有技术栈的兼容性,包括 Python 依赖、模型接口、工具协议、任务定义方式和评测方式。源代码规模较小不等于接入没有成本,官方示例、文档完整度、调试工具和社区反馈,都会影响国内开发者能否快速完成迁移。
后续可以观察三个方向:一是 Agent Lightning 能否支持更多类型的智能体与工具;二是训练稳定性、资源消耗和复现实验是否足够清楚;三是这种“训练与部署共用 harness”的方法能否从研究样例进入企业内部工作流。若这些环节逐步成熟,它才可能成为智能体工程中的常用训练层。
同主题阅读路径
查看「模型发布」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具