Ai2 开源 AstaBrief 8B:把研究问题和检索片段直接拼成带引用的科学报告
Ai2 把一款 8B 参数的科学报告生成模型 AstaBrief 开源,基于 Qwen3-8B 改造,能把研究问题和检索到的文献片段自动组织成带引用的报告,并随模型一起放出训练数据。
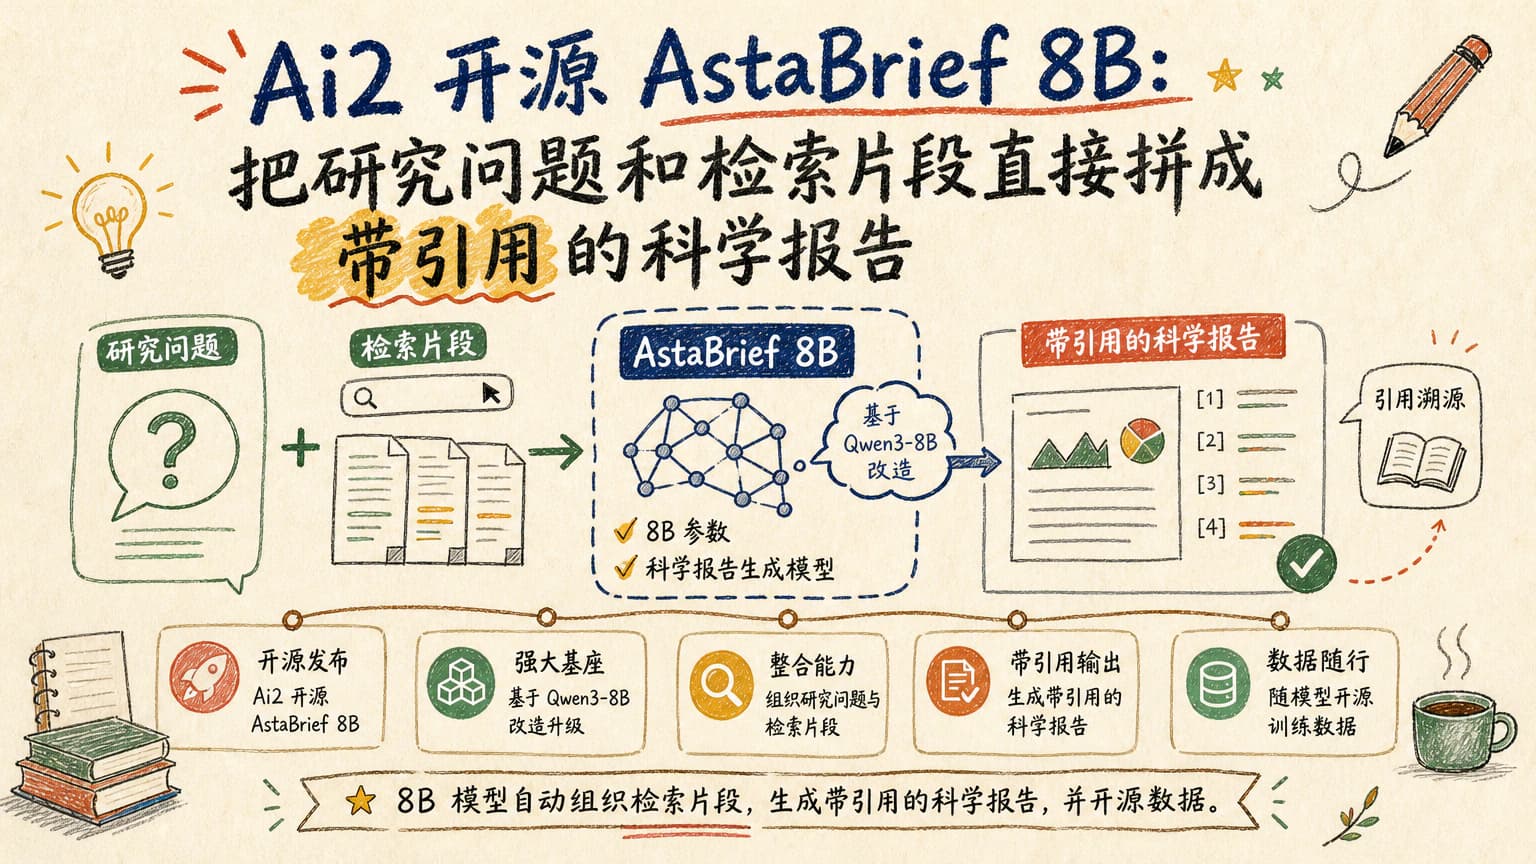
美国非营利 AI 实验室 Ai2(Allen Institute for AI)近日上线并开源了 AstaBrief 8B,这是一款专门写科研报告的小模型,体量被压到 80 亿参数,却把“研究问题 + 检索片段 → 带引用报告”这件事做成了一条单一流程。
它到底在解决什么问题
科研人员现在不缺检索工具,缺的其实是把检索结果整理成初稿。学术写作里最花时间的,往往不是找文献,而是把零散片段拼成可读文本,并在每一处结论后面挂上正确引用。AstaBrief 直接把这一段工作自动化:给它一个研究问题和若干候选文献片段,它能输出段落级别的回答,并标注信息来源。
它站在哪个底座之上
模型基于阿里通义千问的 Qwen3-8B 进行后训练改造,而非从零训练。这意味着团队把主要精力放在“科学写作行为”上:怎么引用、怎么取舍、怎么在证据不足时收敛表述,而不是和参数规模较劲。这也是近一年来不少垂域小模型共同选择的路线——用现成强底座,靠数据和后训练塑造专业能力。
数据和训练方式一并开放
和单纯放权重不同,AstaBrief 连同训练数据一起开源。团队公开了用来训练这种“报告生成 + 引用”行为的合成数据,让外部研究者能够复现、改造或拓展到自己的领域。对做检索增强生成(RAG)和科研类应用的人而言,数据往往比权重更稀缺。
对开发者和科研用户的实际意义
第一,写文献综述初稿的门槛被拉低。学生、研究生、综述作者可以让它先出一稿,再人工校对引用与表述,效率提升明显。对中文使用者来说,一个重要判断是:这仍然是一个英文写作模型,用它生成中文综述,引用样式和段落习惯都需要后处理。
第二,企业知识库团队可以把它当作“带引用写作”的参考实现:模型只接受少量检索片段就能生成结构化输出,便于嵌入内部 RAG 流水线。第三,独立开发者能拿现成训练数据微调自己的领域版本,例如医学、法学或工业研发场景。
它在 Asta 里的位置
AstaBrief 已经作为 Fast mode 接入 Ai2 的 Asta 平台 “Generate a report” 功能,区别于更慢、更强但耗资源的生成路径。这意味着 Ai2 把它当成一个长期维护的产品组件,而不仅仅是研究展示。后续是否能进入收费版、企业版或 API 服务,是值得观察的走向。
和同类工具的横向参照
市面上已有 Elicit、Consensus、ResearchRabbit 等“AI 文献助手”,但多数走 SaaS 路线,模型与数据不开放。AstaBrief 的差异化在于:开源、可自部署、连训练数据一起放出。这让它更适合机构内部部署和对数据合规有要求的科研单位,而不是个人轻度使用。
给中文用户的几条提醒
不要把它当作最终输出机,而是当作初稿引擎;引用必须人工复核,AI 生成的引用仍有错配风险;如果需要中文输出,需要额外加一层翻译/改写层;关注后续是否出现社区微调版本,例如面向中文论文或特定学科的版本。
后续值得观察的几件事
模型在长报告、多子任务上的稳定性;社区是否会基于其训练数据做出中文或学科特化版本;Ai2 是否会把它接入付费产品线;以及是否会出现更小、更便宜的蒸馏版本,让个人笔记本也能跑得动。
同主题阅读路径
查看「模型发布」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具