Vicuna-13B开源聊天模型来了:300美元复现九成ChatGPT质量,对中文用户意味着什么
LMSYS团队发布Vicuna-13B聊天模型,使用约7万条ShareGPT对话微调LLaMA,训练成本约300美元,权重与代码以非商业许可公开。GPT-4盲测中质量达ChatGPT九成,但中文能力、许可范围和评估方法仍有明显限制。
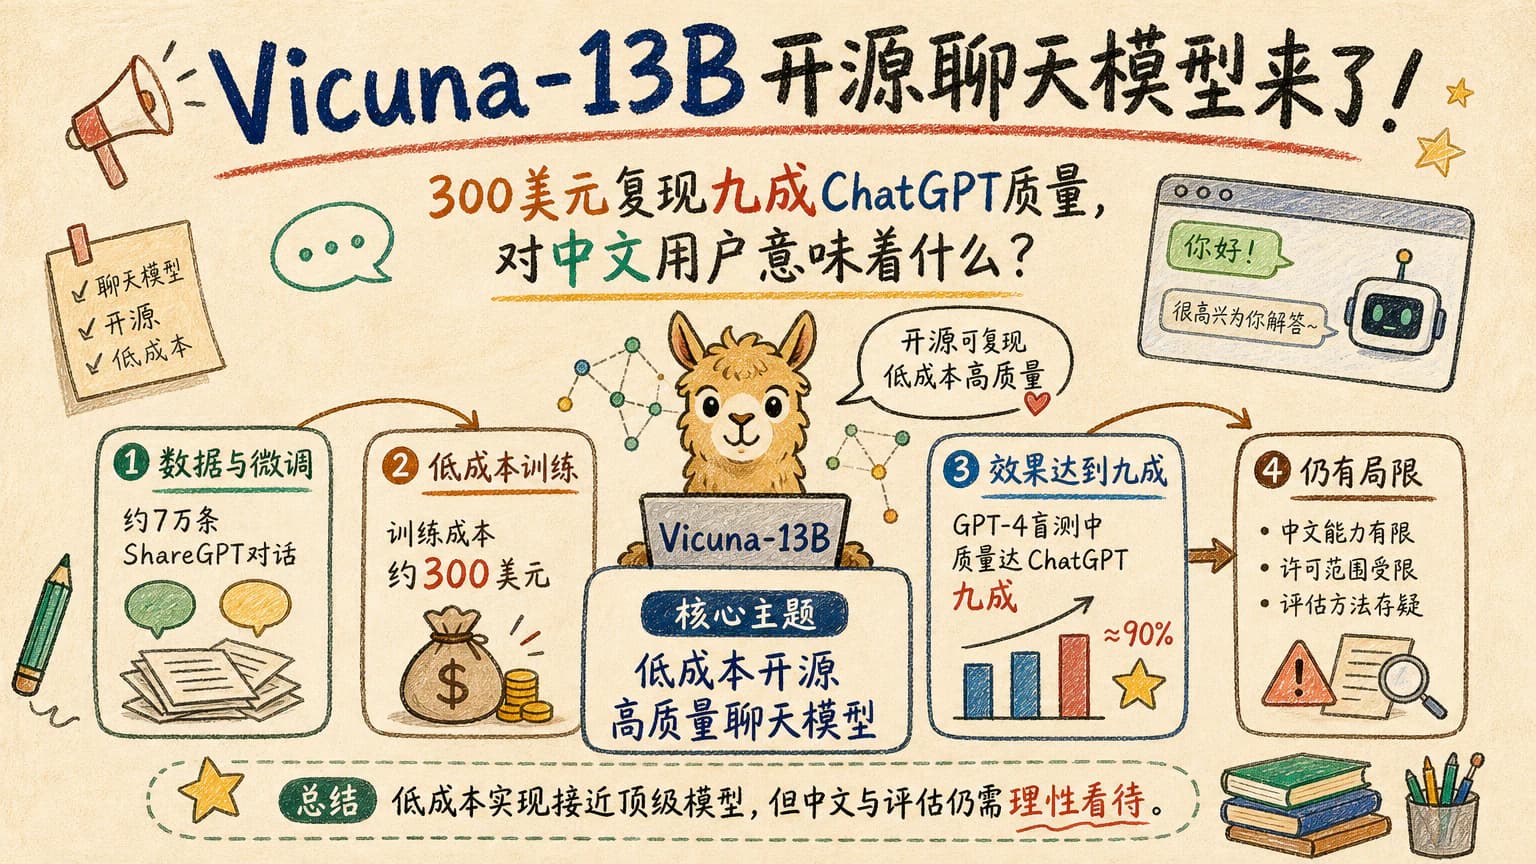
把 ChatGPT 拉下神坛的成本可以有多低?LMSYS 团队给出的答案是三百美元。他们用约 7 万条来自 ShareGPT 的真实用户对话数据,对 Meta 开源的 LLaMA 底座做了微调,发布了一个名为 Vicuna-13B 的对话模型,代码、权重和在线 Demo 都以非商业许可公开。
事情的关键不在于多炫的指标,而在于门槛被拉到了什么位置。当一个具有 ChatGPT 约九成对话质量的模型,能在一天之内、用几百美元单机训练出来,研究者、小团队甚至个人玩家的玩法都会被改写。
Vicuna 做对了什么
训练数据是 Vicuna 区别于其他开源模型的核心。它没有依赖传统的网页爬取语料,而是直接采用 ShareGPT 上用户自愿分享的 ChatGPT 真实对话记录——问题更口语,追问更密集,逻辑也更接近日常使用场景。LMSYS 表示,他们对原始数据做了清洗,把约七万条对话补写完整,把单条过长的内容裁剪成可训练的窗口。
在微调方案上,团队没有从零训练,也没有改 LLaMA 的结构,只是在 LLaMA-13B 上继续做有监督微调。这把显存和算力需求压缩到单卡 A100 级别,也让复现链路变得很短:任何熟悉 Hugging Face 工具链的工程师,都可以照着他们的脚本再来一遍。
90% 这个数字怎么来的
评估方式值得单独说一说。LMSYS 没有用常规的学术 benchmark,而是把 Vicuna、Bard、ChatGPT、参数量更小的基座模型放到一起,让 GPT-4 当评委做盲评,再计算 ELO 风格的质量得分。
结果显示 Vicuna 在中文、英文对话以及角色扮演类问题上都能与 Bard 接近,整体质量达到 ChatGPT 的九成以上,在大约 45% 的题目上甚至拿到平手或更优的评价。
这个方法不够严谨,但它的指向很清晰:真实对话质量,和学术榜单并不完全是一回事。LMSYS 自己也强调,基于 GPT-4 的自动评测会偏向冗长、格式化的回答,在事实性、安全性上未必可靠,建议作为补充而非替代手段。
对中文开发者和创作者的直接影响
先说一个好消息:Vicuna-13B 的底座是 LLaMA,词表以英文为主,对中文的覆盖并不算充裕。在不额外做中文词表扩展和继续预训练的情况下,它直接跑中文对话的能力会明显弱于英文,尤其是专业术语和复杂长句。
但坏消息的反面也是机会。如果团队愿意基于 Vicuna 继续做中文领域的指令微调,或者叠加检索增强、结构化提示词工程,它在中下游产品里的可用性会显著抬升——尤其是角色扮演、本地知识库问答、轻量写作助手这类对事实性要求不那么苛刻的场景。
许可、使用和后续动作
需要警惕的是 Vicuna 的开源许可并不是宽松的开源协议。模型权重和代码基于 LLaMA 的非商业许可与附加条款公开,禁止用于年收入超过七百万美元的产品,也禁止商用打包分发。这意味着它更适合研究、内部评测和原型验证,而不是直接拿来做 SaaS。
后续值得盯的几条线:中文社区是否会出现针对 Vicuna 的二次微调版本;线上 Demo 的并发承载和被滥用风险;以及 GPT-4 评委这套机制会不会扩散到更多模型对比中。更长期看,300 美元级别的微调成本,会让中小团队更容易产出自己的“行业版 ChatGPT”,也会把模型层的竞争压力继续向应用层挤压。
同主题阅读路径
查看「模型发布」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具