一行装饰器把多机训练拉进日常:Modal Clusters 正式开放意味着什么
云端 AI 基础设施公司 Modal 把多节点 GPU 集群做成一个 Python 装饰器,自动配 InfiniBand 和 NCCL,省掉工程团队大量底层工作。对独立开发者、中小团队和中文 AI 创作者来说,过去只有大厂才玩得动的分布式训练,开始变成按小时租的资源。
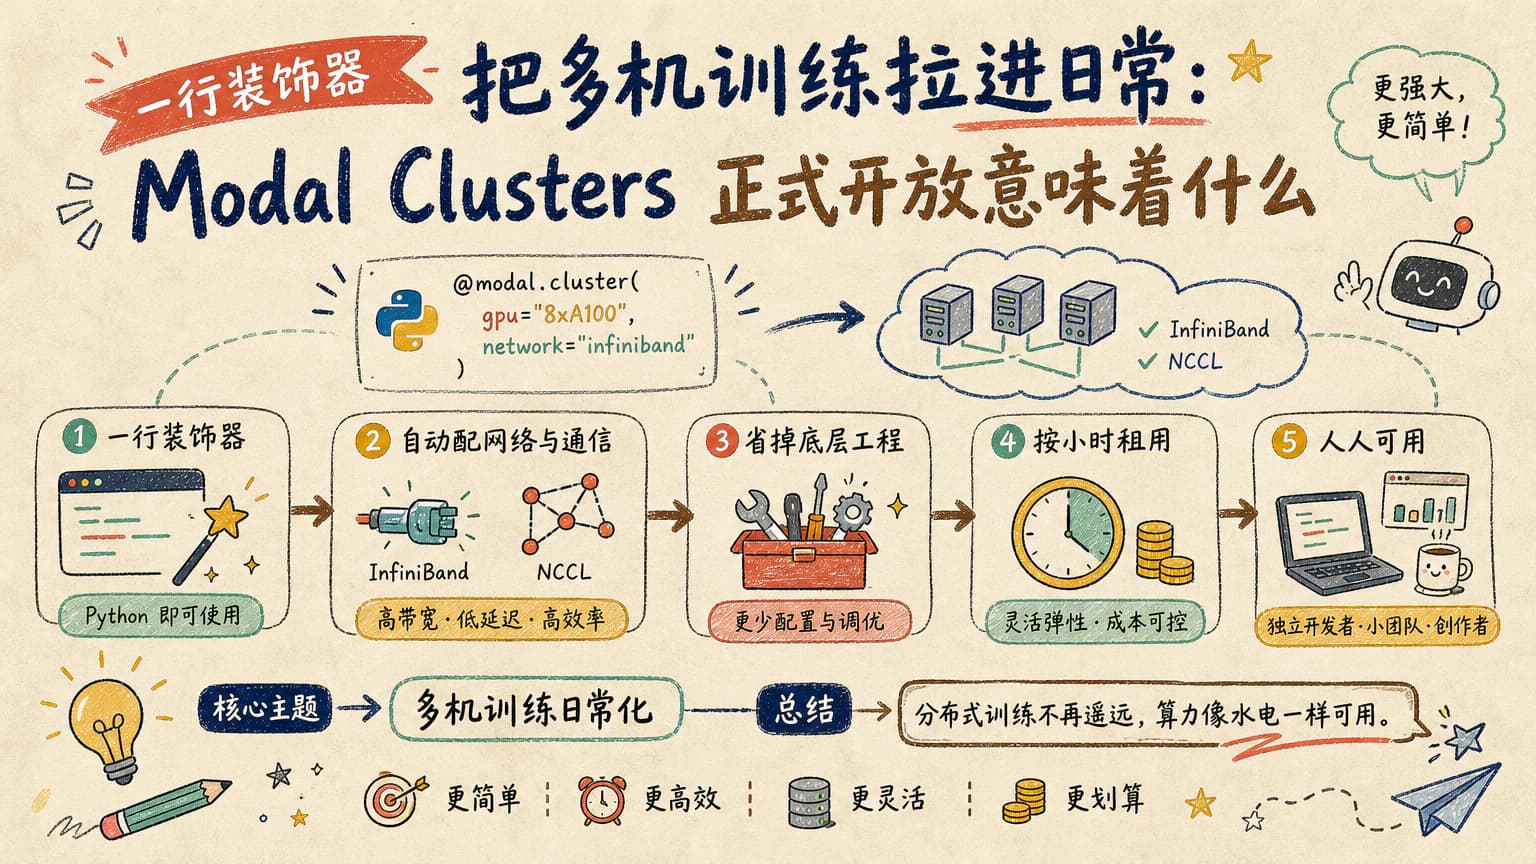
把多机分布式训练写成一个装饰器,是 Modal 最近一次让人停下刷新的更新:开发者只要给函数加一行 @modal.clustered,云端就会自动拉起多节点 GPU 集群,节点之间走 InfiniBand verbs,官方给出的带宽数字是 6.4 Tbps。
听起来又是一个新概念,但对真正写过分布式训练的人来说,这背后是一长串平时看不见的苦活:NCCL 通信库配置、InfiniBand 驱动调优、RDMA 路由、节点拓扑对齐、故障时重连——这些工作长期由大厂基础架构团队承担。
Modal 的做法是把它们做成一类声明式的接口,让研究人员直接写训练逻辑就行。公告里强调会自动配置 PyTorch 和 NCCL,这意味着用户无需手动指定主节点地址、端口和通信后端。
装饰器背后藏着的工程取舍
业内熟悉多机训练的人会知道,难点并不在调用几个 GPU,而在于把延迟敏感的张量通信做到接近单机 GPU 直连的水平。InfiniBand verbs 比传统 TCP 高出一个量级,但需要网卡、驱动、内核和 NCCL 版本协同。
Modal 把这些细节封装进 @modal.clustered,本质上是把平台层的硬件知识隐藏起来,换取一个更短的开发者心路。对小团队来说,这意味着不再需要专门雇一位懂 RDMA 的工程师。
但封装也意味着权衡:可调的底层参数变少,调试黑盒变深。对那些已经在自建集群上跑过 ResNet、LLM 预训练、微调流水线的团队,迁移到 Modal 之前要先想清楚排障流程能不能接受。
对不同身份的开发者意味着什么
独立开发者和中小团队是最直接的受益方。以前他们要在 Lambda Labs、RunPod、AWS 各家之间比较 GPU 价格和可用性,还要看有没有原生多机支持。现在一行装饰器就能让代码扩展到多节点。
对中文 AI 创作者,尤其是做小规模实验验证、开源复现和论文复现的人,这种"用最少代码跑最多机器"的体验,可以把原本一周的环境搭建压缩到几小时。
企业用户更需要看的是数据合规与计费模型。集群级别算力单价不低,按小时租的多节点 GPU 是否划算,取决于任务类型:长任务、对通信敏感的大模型预训练更敏感;短任务、微调推理评测则更容易摊薄成本。
中文用户更该关心的两件事
第一是"在哪用"。Modal 总部在美国,节点分布和跨境网络质量会直接影响中国大陆开发者的实际体验。长时间训练任务一旦遇到网络抖动,断点续训和容错设计就成为关键。
第二是"和谁比"。Anyscale、Replicate、Fireworks、Together 等平台都在做开发者友好的 AI 基础设施,但它们侧重点不同:Modal 偏重端到端的运行环境抽象,更像无服务器函数;其他平台则更接近传统 IaaS。
后续值得观察的点
接下来要看 Modal 能不能在真实负载下保持宣传中的带宽数字。6.4 Tbps 是理论上限还是常见区间,要等首批大规模任务的基准出来。
另一个观察点是和主流训练框架的兼容性。PyTorch 之外,JAX、DeepSpeed、Megatron-LM 等组合能不能同样无缝,决定了它对研究型用户的影响力。
对中文世界而言,最值得追踪的不是这个产品本身,而是"云端多机训练"是否会成为新一轮 AI Infra 的标配。当装饰器级别的抽象把分布式训练变成普通 API,AI 创新的门槛会再次下移。
同主题阅读路径
查看「产品动态」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具