Claude Opus 5.5 拿下 Text Arena 第一,对中文用户意味着什么
Anthropic 最新模型 Claude Opus 5.5 以 1509 分登顶 LMArena 文本榜,超过前代 18 分。Anthropic 一家包揽榜单前六,模型价格与性能同时进入 Pareto 前沿。对中文开发者与企业用户来说,这意味着更强的写作、代码和长上下文能力即将落地。
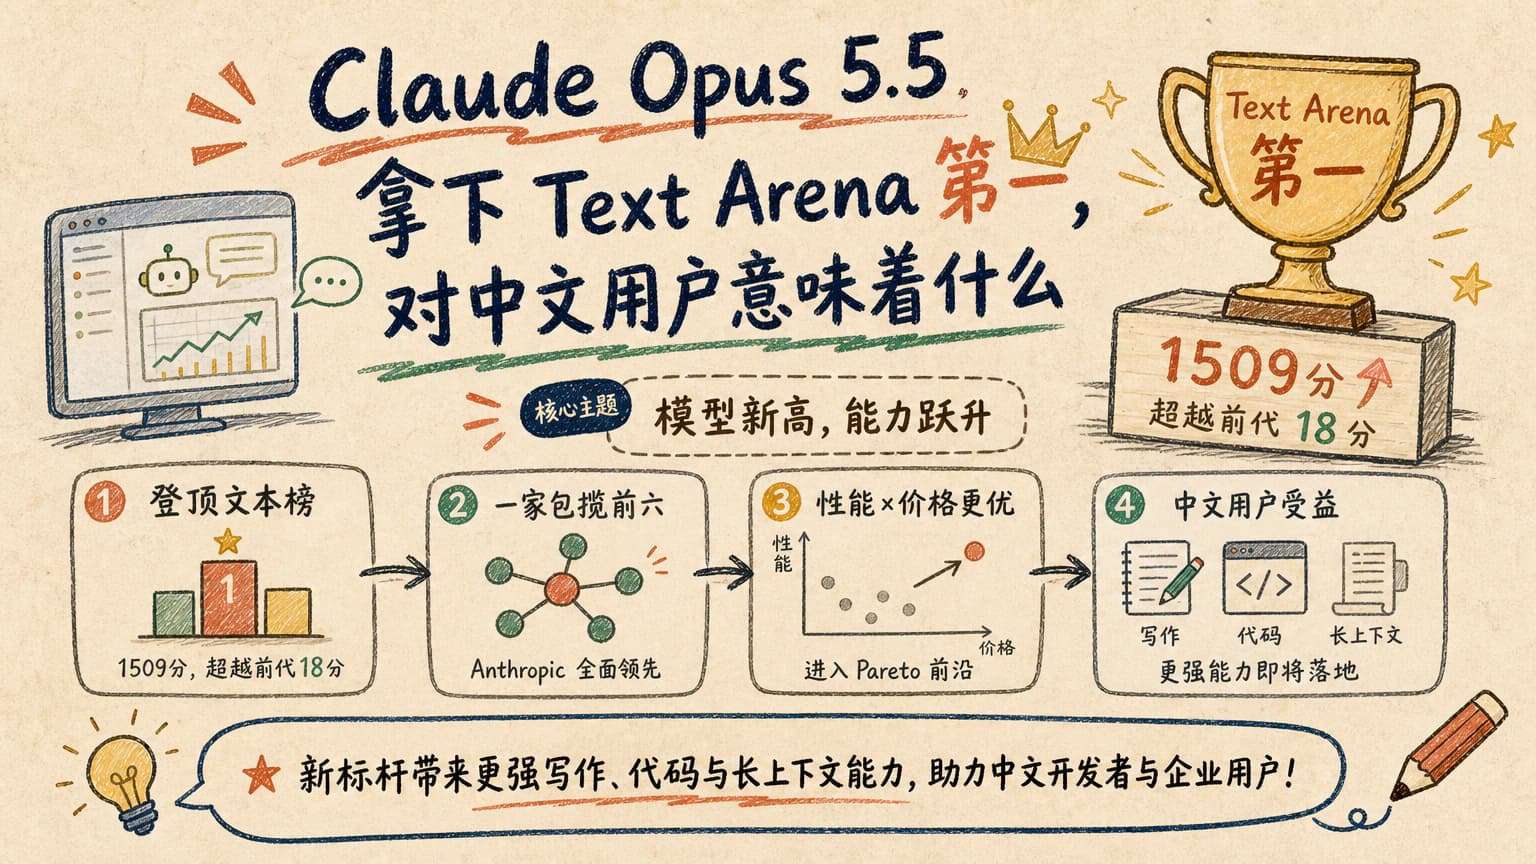
大模型竞技场 LMArena 又一次更新了榜首,这次的主角是 Anthropic 的 Claude Opus 5.5 高负载档位。该模型以 1509 分的成绩首次坐上 Text Arena 第一,把自家前代 Opus 5 高负载档位甩开 18 分,后者目前已经滑到第十一名附近。
从榜单结构看,这次更新比单一排名更值得讨论。Anthropic 一口气拿下了 Text Arena 前六名,Opus 4.6 高负载档位以 4 分之差守在第二。也就是说,第二名到第六名都属于同一家公司,这在主流榜单里并不常见。
模型本身的几个关键变化
1509 分的差距并不算夸张,但它来自“盲测对战”,意味着大量真实用户在没有品牌滤镜的情况下给出了偏好。换句话说,提升的是大多数人日常使用时的体感,而不是某一个窄指标的极限分数。
新模型在 Arena 的 Pareto 前沿上也留下了自己的位置。按每百万 token 的输入和输出折算,Opus 5.5 高负载档位的混合价格大约是 16 美元。这个数字比上一代更激进,意味着它不是在比“最贵最强”,而是在挤进“又强又不算贵”的区间。
对中文开发者和创作者的直接影响
对中文用户来说,最直观的感受会落在长上下文、写作风格和代码能力上。Opus 系列过去在中文长文改写、文案口吻控制和复杂代码重构上有不错的口碑,新版本如果延续这条路线,会更适合做长篇内容生产、技术文档写作和多轮 Agent 任务。
企业用户则更应该关注价格档位的变化。Pareto 前沿意味着同样的预算可以拿到更强的模型,这对自动化客服、内部知识库、营销文案生成这类“量大但单价敏感”的场景非常关键。
与 OpenAI、Google 的格局变化
Anthropic 一家包揽前六,是这次榜单最具信号意义的部分。它说明在文本模型的综合体验上,Claude 家族目前形成了一个连续的产品梯队,而不是只有一款旗舰能打。对比来看,OpenAI 和 Google 的主力模型依然在前十,但要在“前六名”这个区间和 Anthropic 直接对话,已经变得更难。
对中文用户来说,这种格局会反映在两件事上:一是 API 渠道和镜像服务里 Claude 系列的可用性,二是国内代理和二开产品对 Claude 5.5 的接入速度。过去每一次旗舰模型更迭,都会有一批中文工具第一时间跟进,这次大概率也不会例外。
现在值得关注的几个点
第一,分数和价格的真实性价比,要在中文任务上重新测一遍。榜单分数是英文盲测的均值,中文写作、翻译、本地化代码注释这些场景,可能和官方分数并不完全对齐。
第二,企业采购要看配额和稳定性。旗舰模型在发布初期往往伴随限速和排队,预算充足的团队可以先做小规模 PoC,再决定是否放量。
第三,个人创作者可以关注降价后的混合档位。16 美元每百万 token 的混合价格,意味着把日常写作任务从 Opus 5 迁到 Opus 5.5,单次成本可能下降而不是上升。
后续值得继续观察
接下来一段时间,最值得跟踪的是 Opus 5.5 在多模态榜、代码榜和 Agent 评测里的表现。文本榜只是它的一张入场券,真正的胜负要看它能不能把领先优势复制到图像理解、工具调用和长流程任务上。
对中文 AI 工具使用者来说,不必急着把所有任务都切到新模型。可以先用一段固定的中文测试集,跑一轮对比,再决定哪些场景值得迁移。榜单之外,自己的数据永远比分数更可靠。
同主题阅读路径
查看「模型发布」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具