Aeon 推出 501B 总参数开源编码模型,23B 激活 MoE 瞄准 Agent 与科研
Aeon 发布文本版 501B-A23B 开源模型 Beam,激活参数 23B、覆盖编码、智能体与科研任务,从零训练、完整权重将以 Apache 2.0 开放,对中文开发者与企业落地值得关注。
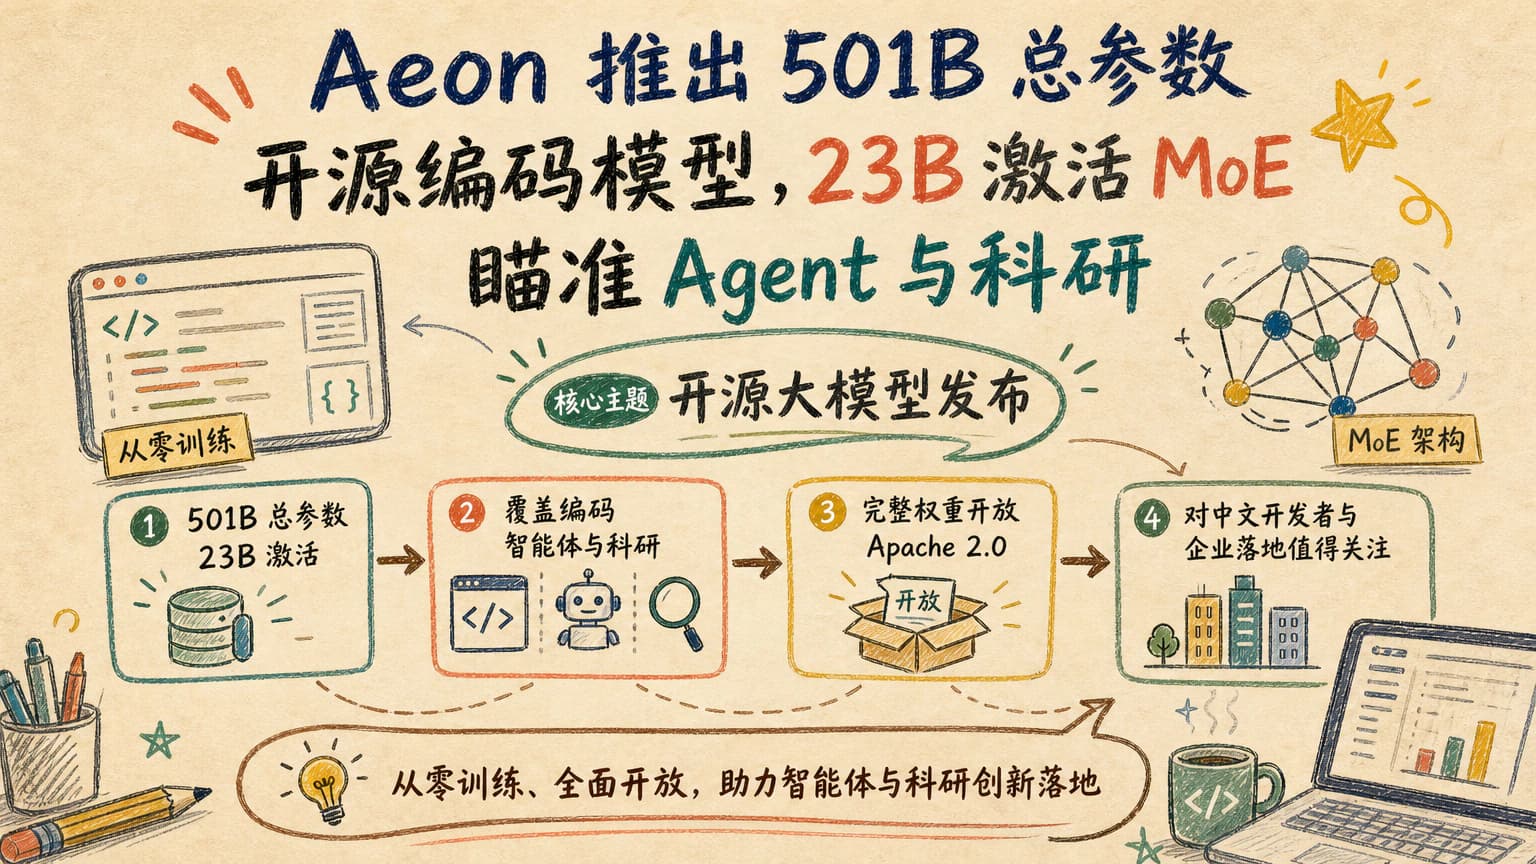
大模型初创公司 Aeon 近日正式公布新一代开源模型 Beam,主打编码、智能体与科学任务方向。这是少数同时具备"大参数总量 + 极低激活量"特点的 MoE 架构:总参数 501B,每次推理仅激活约 23B 参数,官方称为 A23B 配置。
Beam 是一个纯文本模型,没有原生多模态能力。官方强调训练从零开始,没有走"蒸馏 + 微调"的捷径,预计本月在 Apache 2.0 协议下放出完整权重。这意味着开发者可以商用、二次分发甚至重新训练,而不只是一份只读 demo。
为什么是 501B-A23B 这个组合
501B 是当下主流开源旗舰的总参数水平,但 Beam 真正被讨论的卖点在于 A23B。绝大多数 100B 级以上的 MoE 模型,激活参数通常在 30B 到 50B 之间;Beam 把激活量压到 23B,瞄准的是"接近稠密 23B 模型的推理成本"。
对中文用户来说,这种结构的好处非常直接:单次推理显存占用接近 30B 稠密模型,多卡推理或单机部署门槛更低,同时保留 MoE 的容量上限。对于需要本地部署、又不愿意牺牲模型规模感的团队,是一种值得权衡的选项。
编码、智能体与科研,三个场景怎么用
Beam 的官方定位是编码、Agent 与科学任务三块,与当下热门的"模型即工具人"路线一致。编码方面,它对标的是当下主流闭源编程助手;Agent 方面,强调长程任务规划与工具调用;科研方面,则突出数学、推理与文献级问答能力。
需要提醒的是,这三类任务都属于"任务型 AI",而不是聊天或内容生成。换句话说,Beam 看起来不是拿来陪聊的,它的评测重点也是 HumanEval、SWE-bench、AgentBench、GPQA 这类基准,不是写小说或做角色扮演。
中文开发者要关心什么
首先要看清楚训练数据。官方宣称从零训练,但代码、英文论文与英文网页仍是大模型的天然主食,中文任务表现需要等中文榜单与本地化测试出来再下结论。如果主要服务国内用户,建议先在自有数据上做回归测试,不要直接当现成的中文模型用。
其次是显存与推理栈。23B 激活量理论上能在 4 卡 80GB 推理、2 卡 24GB 量化部署,但仍取决于 KV cache 与上下文长度。如果计划用于 Agent 场景,长上下文对显存的占用不能忽视。
开源协议与商用边界
Apache 2.0 是开源模型里最宽松的一档,可以微调、可以再发布、可以在 SaaS 中提供服务,不需要单独协商授权金。唯一需要注意的是品牌与商标条款,以及不要把模型生成的输出直接当作官方背书。
对国内企业来说,这种协议意味着可以直接拿来做二次开发,不必担心"开源但限制商用"的常见陷阱。这也是 Beam 与一些"研究许可证"模型最大的区别。
后续值得观察的几个点
第一,权重实际放出后,社区复现的编码与 Agent 分数是否和官方一致;第二,针对中文场景的中文微调版本会不会出现,以及是否会出现国产中文团队主导的 LoRA 适配;第三,是否有云厂商第一时间接入推理服务,方便不想自部署的用户直接试用。
对国内 AI 工具使用者来说,Beam 的真正意义在于:开源旗舰的竞争已经不再只比"谁的总参数更大",而是开始拼"激活效率 + 任务专精度"。如果中文生态能跟上补位,对想要本地化部署的中型团队来说,2026 年开源编码 Agent 的可选清单会明显变厚。
同主题阅读路径
查看「模型发布」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具