DeepSeek V4.1 Flash 跑分出炉:ARC-AGI 双榜提升,成本也跟着涨 2.5 倍
ARC Prize 公布 DeepSeek V4.1 Flash 成绩:ARC-AGI-1 拿到 94.5%,ARC-AGI-2 拿到 72.9%,比上一代分别高 5.5 和 11.5 分,但单任务成本也涨了约 250%。对中文开发者和企业用户来说,这是一次以推理换取精度的小升级。
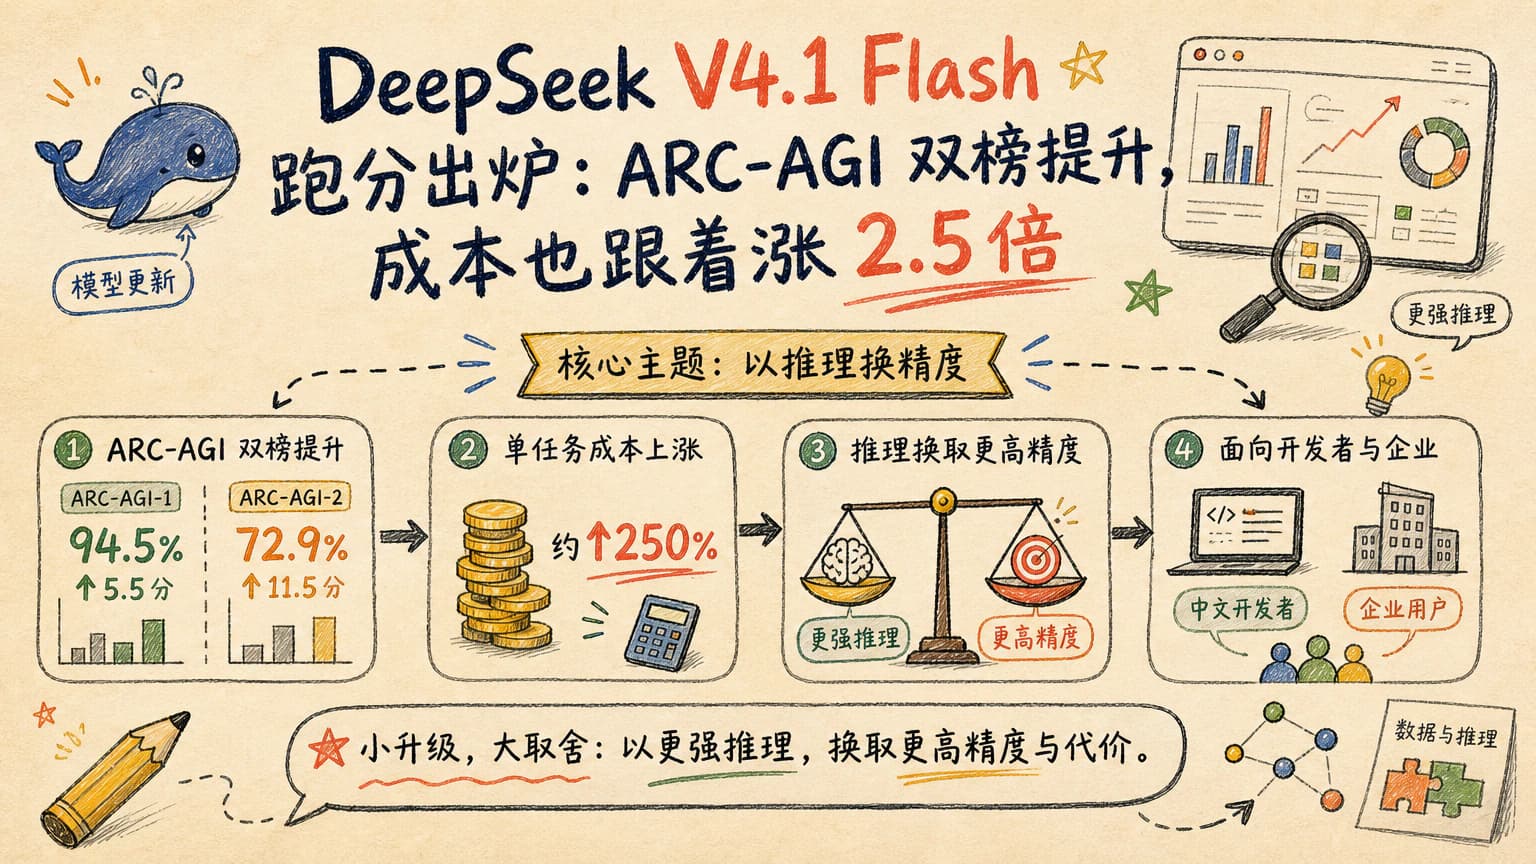
ARC Prize 近日公布了 DeepSeek V4.1 Flash 在 ARC-AGI 官方榜单上的成绩,先看两条核心数据:在 ARC-AGI-1(Verified)上拿到
94.5%,在 ARC-AGI-2(Verified)上拿到
72.9%。
对照上一代 V4 Flash 的最佳成绩,V4.1 Flash 在 ARC-AGI-1 高出
5.5 个百分点,在 ARC-AGI-2 高出
11.5 个百分点,难度更高的 ARC-AGI-2 涨幅更明显,这意味着新版本在多步推理和复杂模式迁移上确实有提升。
不过代价也摆在账单上:ARC-AGI-2 单任务成本约 0.13 美元,ARC-AGI-1 单任务成本约 0.07 美元,整体推理成本比 V4 Flash 高出大约 250%。同一个模型,能力更强了,钱也花得更多了。
为什么 ARC-AGI 这个榜单值得看
|ARN ARC-AGI 由前谷歌研究者 François Chollet 推动,主打“衡量模型是否真正具备通用推理能力”,题目是抽象的网格模式变换,不靠记忆和刷题就能推导出规则。它的目标是测试模型是否会“解决问题”,而不是会不会“复述答案”。
对国内做小模型、轻量推理的人来说,ARC-AGI 一直是一面干净的镜子:题目公开、数据量小、规则透明,任何人都能本地复现,分数高就值得研究,分数低也别找借口。
数字背后的取舍:能力涨了,成本怎么算
把 V4.1 Flash 放到企业场景里看更直观。假设一个文档解析产品每天要跑 10 万个 ARC-AGI-2 风格的逻辑题,从 V4 Flash 切到 V4.1 Flash,单任务成本 2.5 倍上涨,意味着日账单会出现明显跃迁。
但换来的 11.5 分提升,意味着更少的“答错返工”。如果人工复核成本很高,一次答对的边际收益可能超过 0.06 美元的单价上涨。这才是开发者真正要在意的地方:能力成本比。
对个人开发者和学生用户来说,更敏感的是 API 价格。DeepSeek 一直以低价出牌,这次成本上升也是一个信号:免费午餐已经吃完,下一代模型会进入“能力-成本”的精细博弈。
对开发者、创作者和企业用户的影响
对独立开发者,V4.1 Flash 仍然适合做需要推理能力的小工具,例如自动化测试用例生成、数据校对、教学辅助,但要把成本估算写进产品的财务模型,不要默认按上一代定价。
对内容创作者,V4.1 Flash 的意义更多在参考:Flash 系列代表“轻量+推理”的折中路线,它能让本地 7B 到 14B 量级的应用覆盖更难的逻辑题目,创作者可以把它当作推理能力的上限参考。
对企业用户,这次升级提醒一件事:升级模型不能只看榜单,要看自己的任务结构。如果业务里 80% 是简单问答、模板填充,V4 Flash 可能更划算;如果是合同审阅、代码重构、复杂规划,那 V4.1 Flash 的提升值得做小规模 A/B 测试。
中文用户应该关注什么
第一,用中文任务测一遍 ARC-AGI 风格的题目。排行榜是英文网格题,落到中文场景里,能力衰减幅度自己才知道。第二,留意 DeepSeek 是否会发布专门针对 Flash 的部署工具或蒸馏版本,本地玩家最关心能不能用低成本硬件跑起来。
第三,关注 DeepSeek 的 API 价格表是否同步调整,成本数据决定它能不能继续当国内小团队的默认模型。
这次升级的关键判断很简单:V4.1 Flash 是一份“能力变强、价格上涨”的答卷,值不值得换模型,取决于你更在乎推理质量,还是更在乎预算下限。
后续可以观察的点
|ARN ARC Prize 在 2025 年底前还要公布更多模型成绩,V4.1 Flash 的位置是“更高、更贵”,后面看的是谁能在不显著提高成本的前提下接近这个分数。同时关注 DeepSeek 是否同步放出更长上下文、更低延迟或本地化部署版本,这些都是中文开发者真正能吃到嘴里的升级。
同主题阅读路径
查看「产品动态」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具