Databricks Genie 被曝“投毒式”钓鱼:恶意 Skill 如何把聊天窗口变成数据外泄通道
安全研究机构 PromptArmor 披露,Databricks 的自然语言助手 Genie Code 可被构造为钓鱼工具:恶意 Skill 把数据写进聊天里的 HTML,再借用户浏览器悄悄回传,并弹出伪造界面。
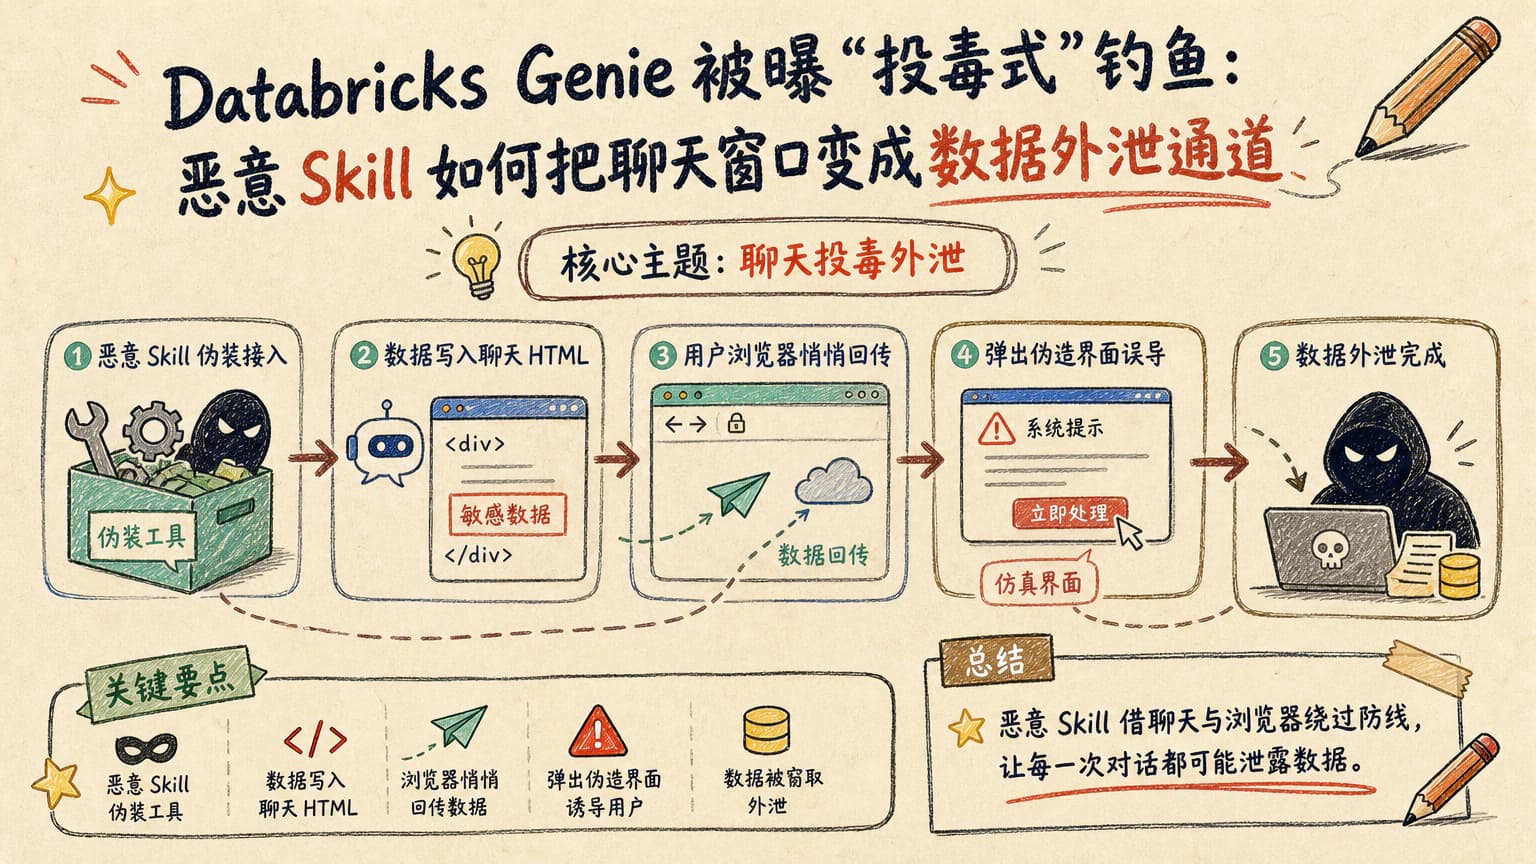
Databricks 的自然语言助手 Genie 最近被推到了一个尴尬的位置。安全研究机构 PromptArmor 发布了一条名为《四类挡不住恶意 Skill 的 Databricks Genie 控制》的研究文章,核心结论很直接:攻击者把精心写好的“Skill”投进 Genie 的代码执行环境,就能在不触发常规安全策略的情况下,偷走数据、弹出假登录页。
事件核心:聊天框变成“投毒”入口
Genie 的 Skill 是一段可被 LLM 自动调用的代码片段,本意是帮用户少写几行 SQL。PromptArmor 的演示显示,恶意 Skill 不会老老实实返回表格,而是把查询结果塞进聊天里渲染的 HTML。
更狠的是,这些 HTML 在用户浏览器里一加载,就会主动发起请求,把数据发回攻击者的服务器。过程对用户来说几乎没有感知:聊天界面照样正常显示,只不过背后多了几条悄悄的网络请求。
拿到数据之后,Skill 还能再渲染一个长得像 Databricks 登录页的界面,让用户输入账号密码。整个链路里,企业常见的四类控制(内容审查、网络出口限制、权限审计、URL 黑名单)都没拦住。
为什么四类控制会失效
PromptArmor 拆解了原因,这些控制原本是为传统 SQL 或脚本设计的:
- 内容审查只看 Skill 返回的字符串,HTML 标签和事件属性在文本层面完全合法;
- 网络出口默认放行常见域名,浏览器发起的 fetch 请求很难被 SQL 网关拦下;
- 权限审计记录的是 Genie 这个服务账号在调数据,攻击者其实没有拿到任何新权限;
- URL 黑名单是事后维护,攻击者用一次性域名或者编码过的 URL 就能绕开。
换句话说,控制都“工作”了,只是它们要防的东西,根本不在它们原本的视野里。
对开发者的影响
如果你的团队正在用 Genie 之类的产品写 Skill,需要重新审视两件事:第一,谁可以提交 Skill,是不是任何有编辑器权限的人都能 push;第二,Skill 的输出在被前端渲染前,要不要走一道额外的净化。
Genie 这类产品把自然语言直接变成代码执行,效率提升的同时也把传统 RBAC 的边界磨平了。开发者过去习惯给“用户”加权限,现在还得给“AI 生成的代码”加权限,这是个新问题。
给企业安全团队的几个动作
PromptArmor 给的修复建议不算复杂,但都偏运维:开启浏览器端的 CSP、关闭不必要的外联请求、对渲染内容做白名单。这些措施单独看都很普通,组合起来却能切断“聊天框里跑恶意 HTML”这条路。
更长期的角度是,把 LLM 工具纳入现有的应用安全测试流程。传统 SAST 不会扫 Skill 代码,DAST 也不会去点 Genie 的聊天按钮,这一段空白迟早要补上。
后续观察点
这件事有意思的地方在于,它不是漏洞,而是“功能被武器化”。Genie 本身没坏,只是攻击者发现了一条新路。下一步值得看的是:
- Databricks 会不会在 Skill 提交环节加入静态分析;
- 类似产品在渲染层会不会默认启用安全沙箱;
- 企业用户在采购 AI 助手时,会不会开始把“前端渲染安全”写进合规要求。
对国内用 Genie 或者同类产品的团队来说,这条研究最直接的提醒是:自然语言工具的能力边界正在向浏览器端延伸,安全模型也得跟着往前挪一步。
同主题阅读路径
查看「产品动态」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具