小米 MiMo-V2.6 修复工具调用重复,复盘里藏着一个被低估的工程成本
小米复盘 MiMo-V2.6 工具调用重复问题,区分并行调用、调用泛滥与调用重复三类异常,提出轻量化修复方案 MOPD,将修复成本压到原 RL 方案的 4%。复盘细节对国内做 Agent 的团队很有参考价值。
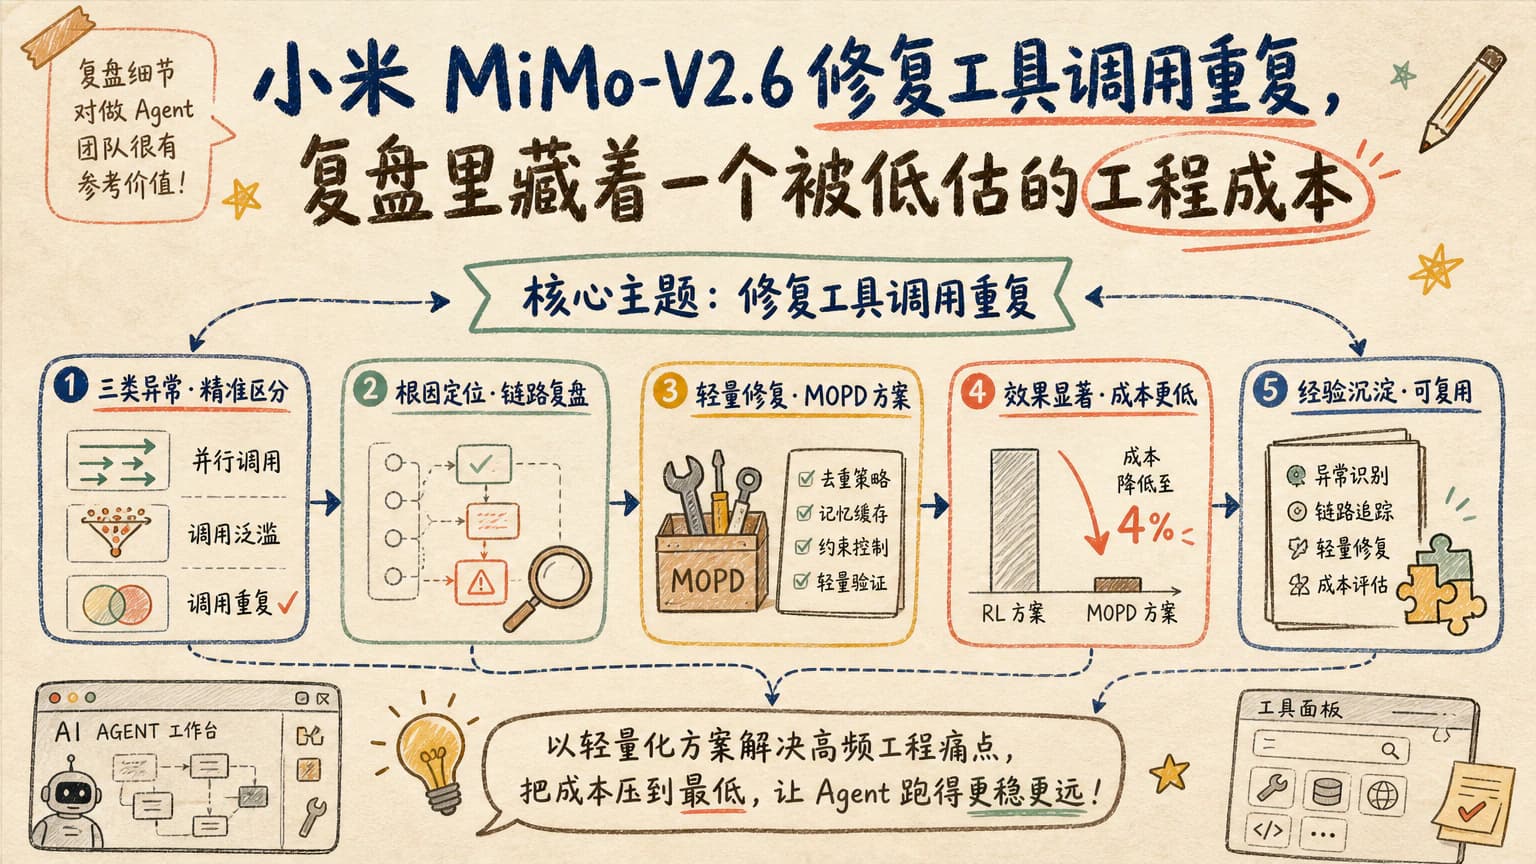
小米官方博客最近更新了一篇有意思的复盘:MiMo-V2.6 上线后,团队发现模型在“工具调用”环节出现了不该有的重复,于是把整个排查和修复过程写了出来。这类文章在国内大模型团队里不多见,比起发布会上的成绩单,这种“翻车日记”反而更值得读。
这次到底出了什么问题
上线后,MiMo-V2.6 的工具调用响应级重复率超过了 0.05%。别看数字不大,在 Agent 场景里,每一次重复都意味着多花 token、多扣钱,甚至可能让任务跑飞。小米团队特意把异常拆成了三类:正常的并行调用、调用泛滥,以及真正的调用重复。区分这三类,是后续定位问题的前提。
训练过程里埋下的根因
团队回放了 MixRL 训练过程中的多个 checkpoint,发现调用泛滥率从训练初期的
11.1% 一路爬升到
24.6%。他们判断,问题出在奖励信号上:32 次调用才触发惩罚,对模型来说太宽松,等于在鼓励“多调几次试试”。这类隐蔽的奖励漏洞,正是 RL 训练中最难排查的一类。
为什么没直接重训
如果简单地把阈值调低,需要重启 20 步 MixRL 训练。官方给出的粗略估算成本约为 231 万美元。更尴尬的是,内部测试里重复率只从
13.45% 降到了
3.83%。换句话说,烧钱还不一定解决问题。对于已经把模型推到线上、跑着真实流量的团队来说,这种权衡几乎是不可接受的。
MOPD:一种更轻的修复思路
最终,小米没有选择重训,而是推出了一个叫 MOPD 的修复方案。文章原文把它的成本压到了原 RL 方案的 4%。从公开信息看,MOPD 更像是一层后处理或补丁机制,绕开重训,直接在推理侧抑制重复调用。细节没有完全展开,但“4% 成本”这几个字本身,就是这套方案最有力的卖点。
对国内 Agent 团队的三个启发
第一,工具调用的奖励设计要尽早做细粒度惩罚,阈值不能等到上线后再补;第二,RL 训练中的异常指标要做 checkpoint 级监控,而不是只看最终分数;第三,Agent 类模型上线后,重复调用这种“隐形浪费”,需要专门的指标和日志来盯。
中文用户可以关注的点
如果你在国内做 Agent、Copilot、自动化工作流类产品,这篇复盘几乎是现成的 checklist:奖励曲线、checkpoint 回放、响应级异常分类、轻量级补丁方案。比起泛泛而谈的“强化学习很重要”,小米这次给出了一个具体可复用的工程样板。
后续值得观察
接下来要看三件事:一是 MOPD 的完整技术细节会不会公布,毕竟“4% 成本”需要更多上下文支撑;二是 MiMo 后续版本是否还会出现类似问题;三是国内其他大模型团队会不会跟进发表类似的“翻车复盘”。一篇坦诚的工程记录,往往比一篇完美的宣传稿更能推动行业往前走。
同主题阅读路径
查看「模型发布」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具