ARC Prize 2026:TUFA Labs以88.06%登顶,ARC-AGI-2高分意味着什么?
TUFA Labs以88.06%的成绩登顶ARC Prize 2026赛季ARC-AGI-2高分榜。该成绩显示其在陌生图形推理任务上的突出表现,但榜单领先仍不能直接等同于通用智能突破。
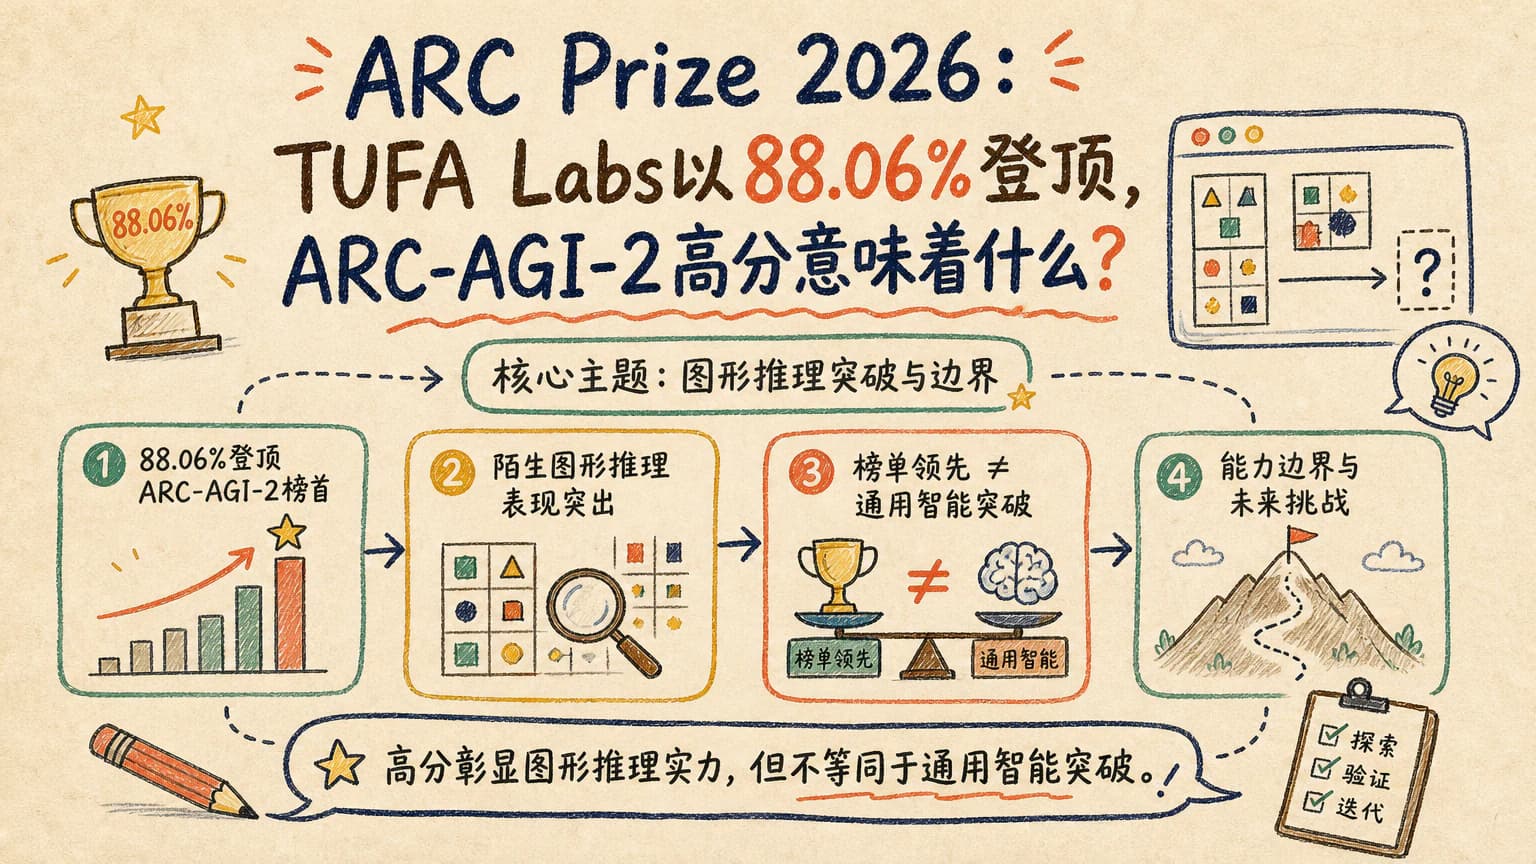
ARC Prize公布了2026赛季ARC-AGI-2高分榜,TUFA Labs以88.06%的成绩位列第一。第二至第五名依次为Rabbithole、Yi-Chia Chen、Nubanana和_hans,具体成绩分别为80.56%、77.22%、77.08%和67.64%。
ARC-AGI系列并非常规图像识别测试,而是通过需要自行理解规则、组合概念的视觉任务,考察模型面对陌生问题时的抽象与推理能力。因此,高分往往比刷过常见基准更接近流体智能,但成绩仍只覆盖特定能力。
登顶成绩与奖金规则
TUFA Labs领先第二名7.5个百分点,这一差距让榜首位置较为醒目。榜单同时设置10万美元奖金,并另设15万美元Bonus Prize,由所有得分超过85%的团队分享;按当前公开信息,TUFA Labs是唯一越过该门槛的团队。
这条奖金规则把竞争重点从“进入前列”推向“跨过85%”。它也意味着,ARC Prize不只奖励单次夺冠,还在鼓励团队尝试更高难度的ARC-AGI-2任务,观察不同方法能否共同逼近或突破现有纪录。
目前公开线索尚未说明TUFA Labs采用的具体模型、训练数据、推理流程或是否进行了任务专门优化。榜单可以证明最终得分,却不能单独说明优势来自基础模型能力、程序化搜索、外部工具,还是多种方法的组合。
高分不等于通用智能突破
对开发者和AI工具用户而言,这次结果更像一项能力信号:模型在要求即时理解新规则、识别结构变化的测试中,已经能够达到相当高的准确率。但ARC-AGI-2任务范围有限,不能直接推导模型具备同等水平的数学、科研或长期规划能力。
对创作者和企业用户来说,更实际的问题不是谁登顶,而是高分解法能否迁移到文档解析、表格处理、界面操作、数据洞察和跨应用工作流。若某套方法确实提高了陌生任务的稳定性,其价值将更多体现在复杂、少样本且规则不固定的工作中。
中文用户应该关注什么
中文用户现阶段可重点看三件事:相关方法是否进入公开产品,是否支持中文材料与本地工作流,以及推理成本和响应时间能否接受。对于国内AI工具使用者,评测名称再亮眼,也不如亲自拿真实任务验证更能说明问题,尤其是规则复杂、输入格式多变的场景。
也要避免把单一分数直接换算成产品体验。榜单通常使用标准化任务和统一评分方式,而真实工作往往包含模糊需求、历史上下文、工具调用和结果复核。高分证明能力上限,真实测试决定可用性。这也是开发者选型时需要坚持的区分。
后续最值得观察的是TUFA Labs是否公开技术细节、更多团队能否跨过85%门槛,以及Bonus Prize最终如何分配。如果高分能够通过通用方法复现,ARC-AGI-2的区分度会进一步下降;若领先依赖特定系统,它反而能成为检验AI抽象推理路线的重要样板。
同主题阅读路径
查看「产品动态」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具