Redwood Research 实测“蒸馏定罪”与“蒸馏提能”:AI 模型蒸馏如何识别来源并阻断风险继承?
Redwood Research 发布论文,对两条模型蒸馏路径进行实证研究:前者尝试识别学生模型是否源自特定教师模型,后者探索在迁移能力的同时避免继承教师模型的失对齐特征。
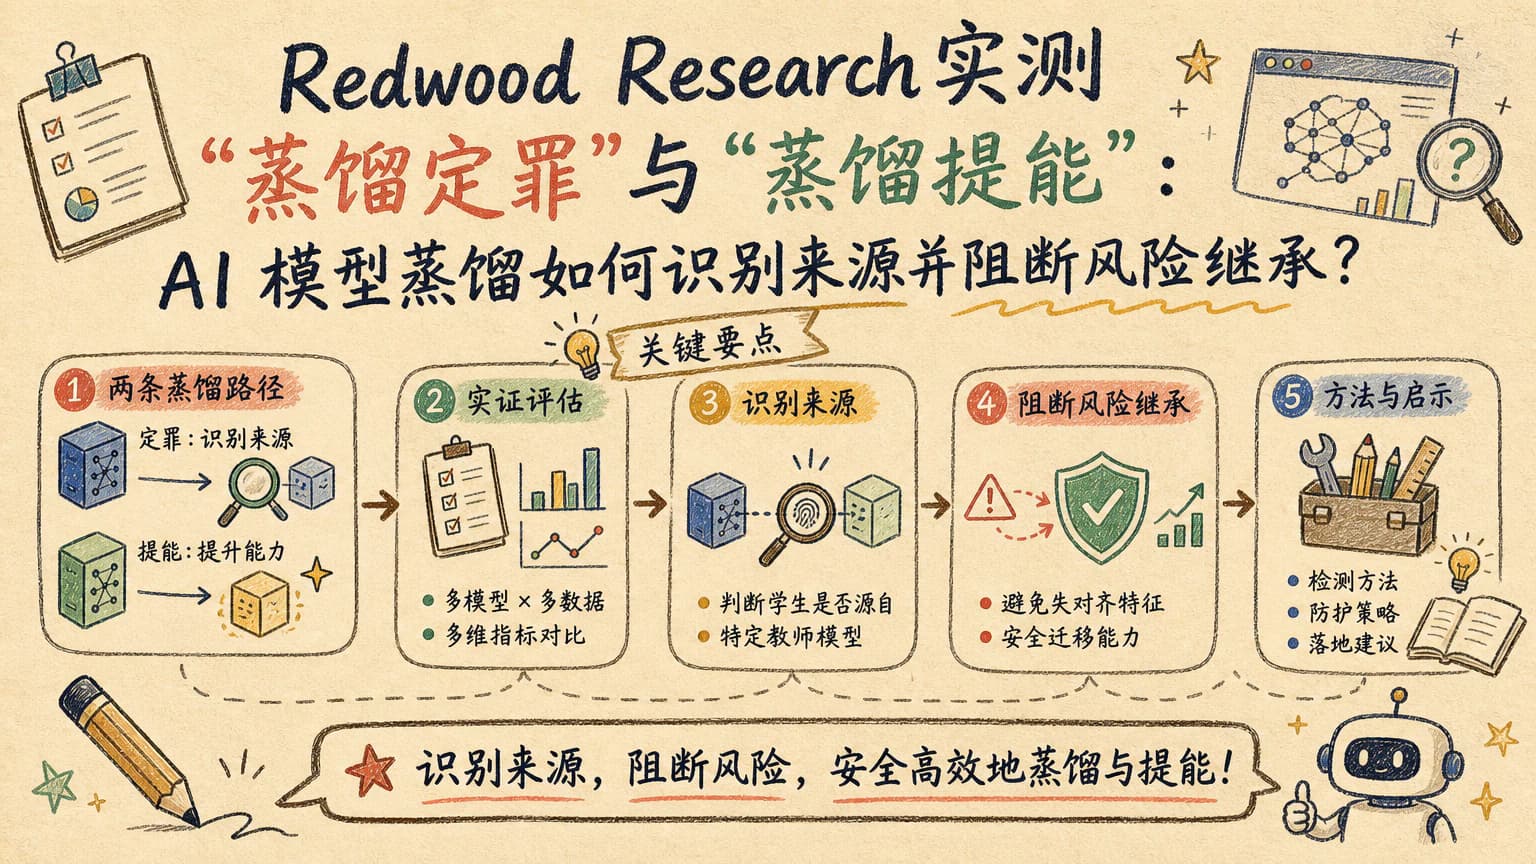
Redwood Research 近日发布论文,围绕模型蒸馏提出并检验两条安全路径:一条被称为“蒸馏定罪”,用于判断学生模型是否借用了某个教师模型的能力;另一条被称为“蒸馏提能”,关注如何在迁移能力时避免风险特征同步扩散。
两条蒸馏路径分别解决什么问题
模型蒸馏通常由能力更强的教师模型生成训练信号,再指导更小、更容易部署的学生模型。现实困难是,能力可以压缩,来源却不容易证明,安全特征也可能随训练数据或监督信号一起被学生模型继承。
按照论文的设定,“蒸馏定罪”并不只是比较两个模型的能力高低,而是寻找教师模型独有的行为习惯。当不信任教师留下的“隐藏怪癖”出现在学生模型中时,研究者可以据此判断二者是否存在蒸馏关系。
“蒸馏提能”走的是另一条路线:它不把目标放在追查来源,而是尝试迁移教师的有效能力,同时阻断失对齐特征进入学生模型。换句话说,前者更像来源识别,后者更接近有选择的能力继承。
从实验室结论到真实使用场景
对模型开发者而言,这两种方法提供了不同的工程思路。如果业务确实需要判断模型是否依赖外部教师完成训练,“蒸馏定罪”可成为模型溯源工具的一部分;如果目标只是用大模型训练小模型,“蒸馏提能”则更贴近部署需求。
对内容创作者和企业用户而言,普通用户通常不会关心模型是否经过蒸馏,但会关心生成结果是否稳定、是否保留原有功能、是否出现教师模型特有的异常表达。安全蒸馏若能在不牺牲实用能力的情况下工作,才可能真正进入生产流程。
真正有价值的目标不是让小模型复制教师的一切,而是只继承可验证的能力。 这也意味着,评估蒸馏效果不能只看最终得分,还要同时检查行为差异、功能完整性与风险特征是否被隔离。
中文用户该关注哪些实际影响
对于使用国内 AI 工具的开发者,最现实的问题是如何在有限算力下获得更可靠的专业能力。论文提出的两条路径提醒大家,训练数据、提示模板、教师输出和评测样本都可能影响最终模型,选择教师不能只看公开榜单。
对海外华人研究者和中文内容团队而言,还可以关注多语言场景下的迁移效果。中文指令、术语体系和文化语境具有特殊性,教师模型在英文环境中的强项,并不等于学生模型在中文任务中同样有效。
需要注意的是,仅凭来源摘要,尚不能确认论文覆盖了哪些模型规模、语言、任务类型和评测指标,也无法据此断言两条路径已经适合大规模商用。其贡献更在于把模型蒸馏中的来源识别与风险控制放进了同一套实证框架。
后续观察点
接下来值得观察的,不只是论文是否公布更多实验数据,还包括方法能否跨模型、跨语言和跨任务保持稳定。若“蒸馏定罪”只对少数模型组合有效,它的溯源价值就会受限;若“蒸馏提能”需要额外成本,其部署优势也需要重新计算。
更成熟的行业方案,可能不会只选一条路线,而是把来源检测、能力迁移、功能回归和安全评测组合起来。Redwood Research 这次工作的意义,是把一个常被简化为“压缩模型”的环节,重新变成可以验证来源、控制继承内容的工程问题。
同主题阅读路径
查看「行业观察」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具