Google DeepMind 发布 Gemini Omni 1.1 Flash:把生成式视频拉进"可控"区间
Google DeepMind 上线 Gemini Omni 1.1 Flash,主打场景扩展、首尾帧控制和 4K 输出三项能力,让开发者在视频生成上首次同时掌控时长、过渡与分辨率,向生产链路更近一步。
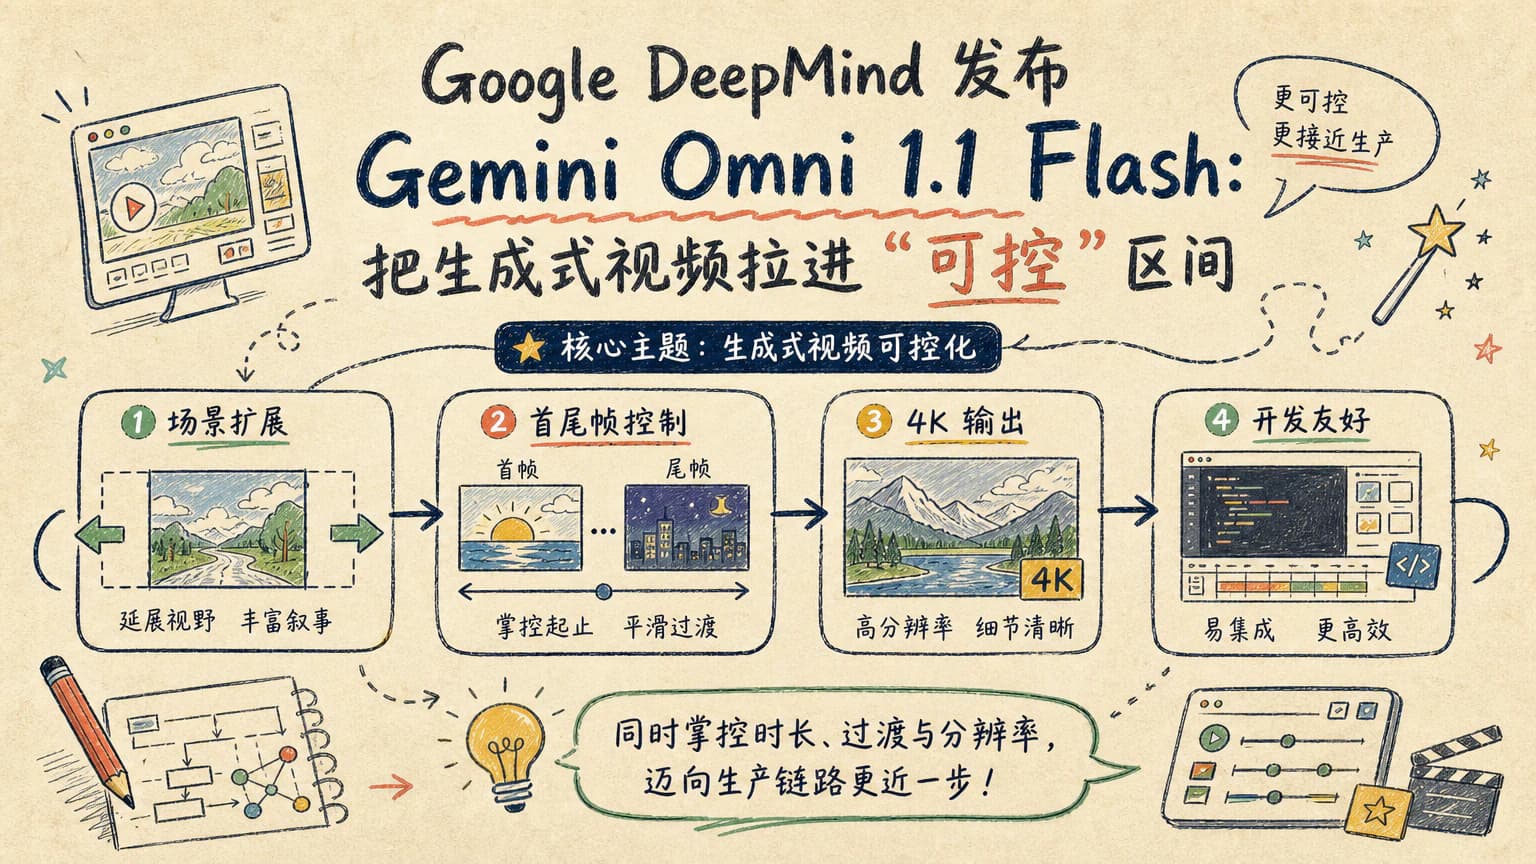
Google DeepMind 推出 Gemini Omni 1.1 Flash 模型,把生成式视频的控制粒度拉到了一个新层级。这次更新的核心不是参数堆砌,而是把“导演权”交还给开发者——你可以决定镜头从哪里开始、到哪里结束、中间怎么过渡。
这次到底更新了什么
新版本主打三项能力:场景扩展可参考前 10 秒画面,以 10 秒为增量向上累计,最长延续 40 秒;支持指定首帧与尾帧,由模型负责补出中间过渡;输出分辨率升至 4K,清晰度与可用素材量都明显提高。
场景扩展并不是简单续写,而是在生成下一段时回头看此前片段,避免人物、配色、光影在多次生成中“漂走”。这正是此前同类工具最让人头疼的稳定性痛点:每跑一次,主角就可能换一张脸。
对开发者和创作者的实际意义
对做短剧模板、广告 demo、互动叙事项目的开发者来说,首尾帧指定意味着可以预先画好关键帧,让模型去补中间过程,比纯文本描述更具可预测性。4K 输出则让素材更接近直接可用,省去放大重绘的步骤。
对独立创作者而言,这一波更新的真正价值不在于画面多“真”,而在于可控性的提升——少几次无效生成,就能省下不少时间与算力成本,把精力放在真正需要决策的环节。
以往用 AI 拍一支 30 秒短片,往往需要拼接七八段、反复重跑。现在上下文窗口拉长、首尾可控,创作者可以把更多精力放在分镜和叙事本身,而不是修补画面细节。
国内用户与后续观察
中国大陆用户目前无法直接调用 Gemini API,但模型一旦通过开源复现,或被国内厂商以类似思路对标,相关工作流会迅速跟进。短期内,更值得关注的是 Vertex AI 与合作伙伴生态对它的承接节奏。
后续值得追踪三条线:第一,4K 输出背后的推理成本与延迟能否压到可商用范围;第二,“首尾帧 + 场景扩展”这套组合,是否会被国内多模态平台快速吸收;第三,更长上下文是否会成为下一代视频模型的标配。
对认真在做视频生成的团队来说,现在是该重新评估工作流的时候了。无论是剪辑模板、电商素材,还是 AI 短剧,新的控制粒度都可能改变原本的人机分工。
同主题阅读路径
查看「模型发布」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具