DeepSeek-V4.1-Flash 发布:百万上下文、FP4 KV 缓存与跨层注意力复用意味着什么
DeepSeek 发布 V4.1-Flash 多模态模型,1M 上下文窗口搭配 8B 激活参数,全局 KV 缓存压到每 token 890 字节,约为 V4-Flash 的 1/4。中文开发者关注的是长文档处理、长对话记忆和推理成本能否同步下降。
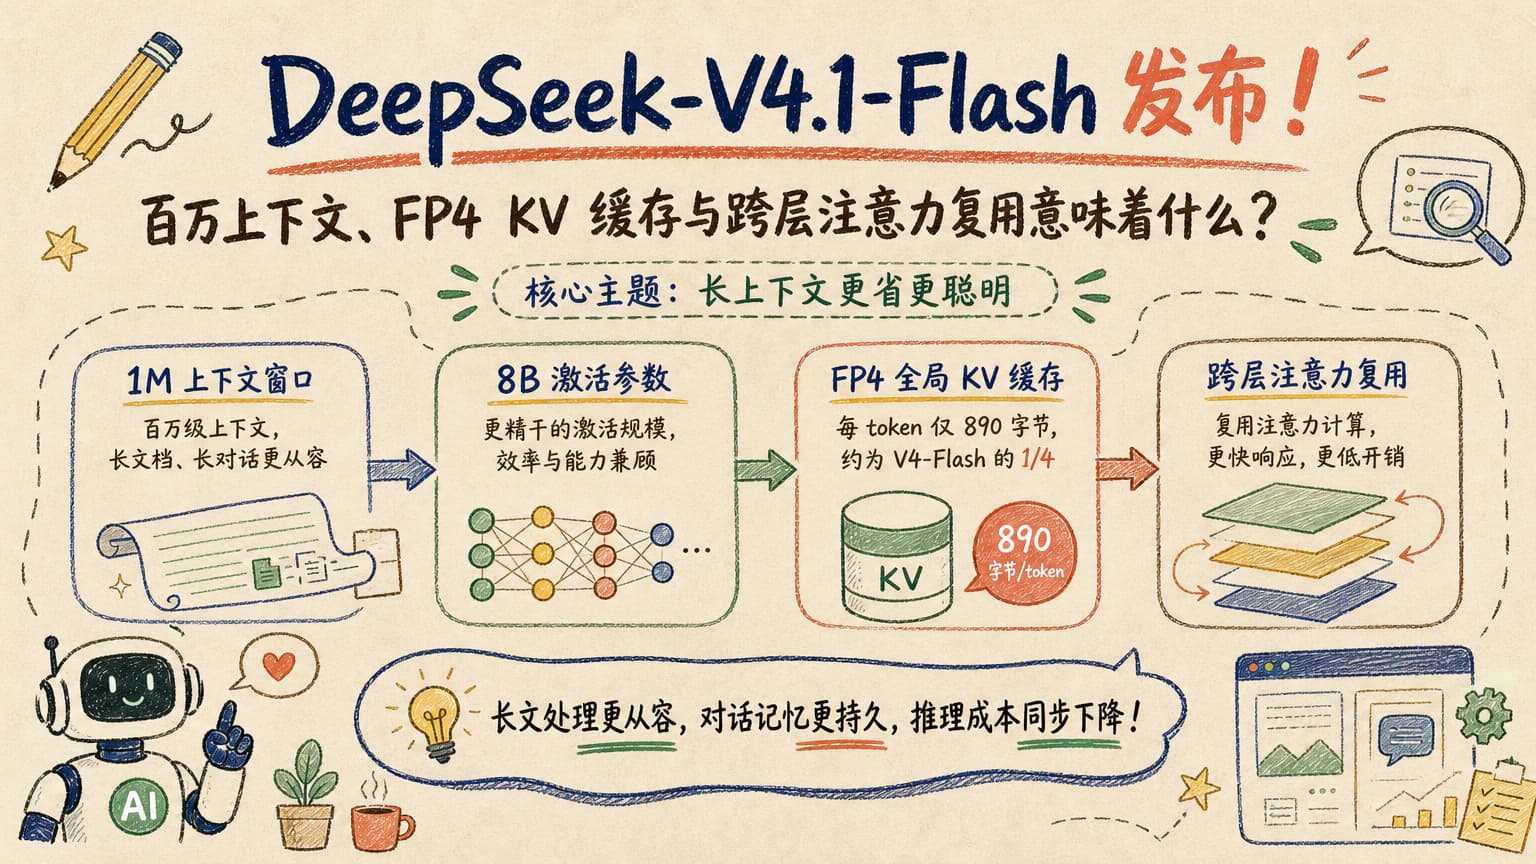
DeepSeek 在 9 月 10 日公布了多模态 MoE 模型 DeepSeek-V4.1-Flash,主干参数 552B、独立的 Engram 模块 196B、上下文窗口放到 1M,prefill 阶段激活 8B 参数、decode 阶段激活 16B。
这组数字放在一起看,重点其实只有一个:在不显著增加推理算力的前提下,把可塞进模型的上下文拉到百万 token 量级。
真正变化在哪:KV 缓存被砍到 890 字节
和 V4-Flash 相比,全局 KV 缓存被压到每 token 890 字节,约为前者的 1/4,也只是 V1 的 1/437。这里同时用到了三个手段:FP4 量化让缓存本身变小,跨层注意力复用(CLA Reuse)让相邻层的注意力图可以共享存储,而 Engram 这一独立模块把固定模式的记忆成本从主路径里挪出来,结果就是长文本推理不再被显存卡死。
对中文用户来说,这意味着同一张卡能跑的对话轮数和单文档长度会明显上台阶,配合 1M token 窗口,做整本技术手册、长合同审阅或多轮带图问答都将更接近“能用”而不是“勉强能跑”。
与 V4-Flash 的差异:不是单纯升级,而是分工
从 MoE 结构和参数规模看,V4.1-Flash 并不是要替代 V4-Flash,而是承担更偏长文本、多模态的推理角色。V4 系列更短更便宜,V4.1-Flash 更长、更吃上下文但单 token 成本更低。两者会长期共存,开发者真正要决定的是“今天这个任务是窗口大重要,还是绝对速度重要”。
对开发者和企业的实际影响
推理侧的最直接收益是 TCO:单 token 显存占用下降后,并发数和吞吐都会上去,长上下文任务的单价会随之下移。对企业客户,这意味着在合同分析、代码库全量检索、RAG 大文档场景中,原来咬不动或要拆段的流程可以一次性塞进去。
对创作者和独立开发者,利好是本地化部署的门槛下降。以 8B 级激活推理配合更小的 KV 缓存,理论上能让消费级显卡承担更长、更多轮的任务;只要生态把对应的推理框架(vLLM、SGLang、TensorRT-LLM 这类)补齐,效果就能立竿见影。
中文场景里值得关注的方向
一是教育和办公:百万上下文 + 多模态,配合中文长 PDF 解析、长会议记录和教材整本阅读,是用户最容易感知的场景;二是国产芯片与端侧推理:低 KV 缓存对显存带宽要求更友好,对国产 GPU 与端侧 NPU 都更友好,能跑多长、有多便宜,是接下来半年观察的焦点;
三是 API 价格策略:成本下降会不会反映在按 token 计费上,是开发者真正的“价格信号”。
还不能下结论的地方
官方目前公布的是结构与缓存指标,还没放出完整的 benchmark、第三方评测和价格表。1M 上下文在多数业务里实际可用比例、跨层注意力复用对不同任务的性能影响、Engram 模块是否对外暴露细粒度 API,都还需要等开源版本和社区复现。
对关心长上下文和推理成本的中文用户来说,先关注的不是榜单分数,而是显存占用和单价——这两项决定了它能不能进入你下一个项目。
后续观察
接下来值得跟踪三件事:开源权重是否真正放出、社区推理栈的适配速度、以及 DeepSeek 自家 API 价格的调整窗口。任何一项落地,都会直接影响中文开发者的工具选型。
同主题阅读路径
查看「模型发布」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具