DeepSeek V4.1-Flash 来了:原生视觉理解、552B MoE,价格打到历史低点
DeepSeek 推出 V4.1-Flash,主打 Causal Encoder-Decoder 新架构与原生视觉理解,552B 稀疏参数、激活 8B/16B,定价再下探。对中文 AI 用户来说,最值得关注的是多模态推理和性价比的同步提升。
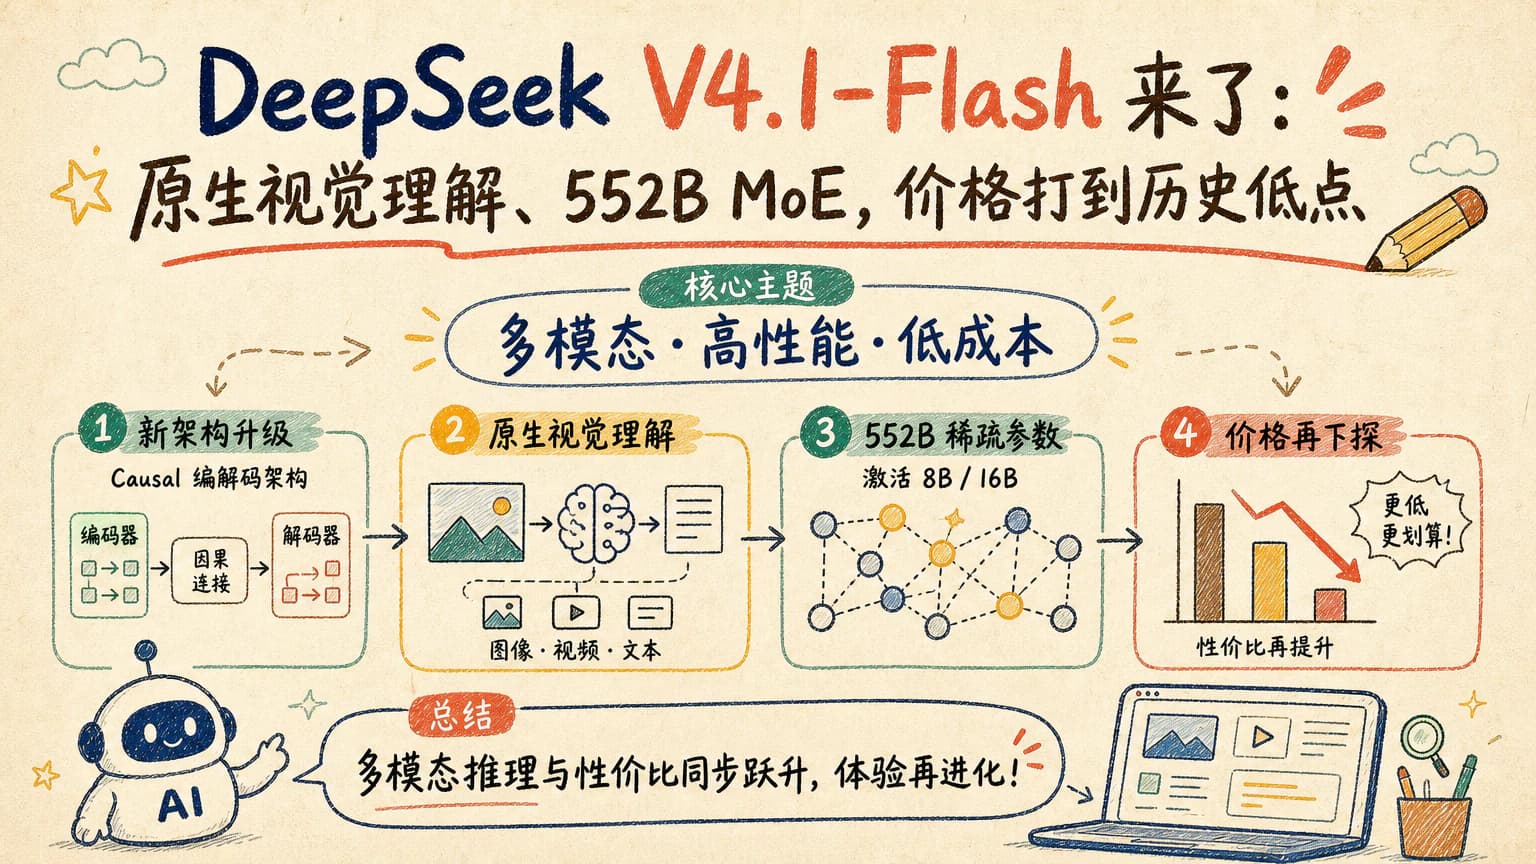
DeepSeek 又一次在节后放新版本,这次是 V4.1-Flash。最显眼的变化是两点:模型从纯文本走向原生视觉理解,同时底层架构换成了一套叫 Causal Encoder-Decoder 的新结构。对国内开发者来说,这意味着过去需要单独接 OCR、目标检测或视觉小模型的工作流,现在有机会被一个统一模型接管。
参数层面的数字也值得停下来看。V4.1-Flash 是 552B 的稀疏专家(MoE)规模,输入端激活 8B,输出端激活 16B。和上一代常见的“输入输出同激活”做法相比,这次刻意把输出侧激活拉大,方向很明确——更看重生成长文本、长推理链,而不是只把上下文吃进去。
这次到底新在哪
原生视觉理解是这次最值得说的点。它不是给文本模型外挂一个视觉塔,而是把图像直接作为输入 token 送进同一套架构。换句话说,模型在“读图”时和读文本走的是同一条路径,少了一层跨模态翻译。
对中文场景更直接的好处是图表、截图、PDF、UI 界面这些高密度信息载体,过去要么靠人工整理,要么要拼一套 OCR + LLM 的组合拳。V4.1-Flash 把这一段压缩成一个调用,错误链路会短很多。
降价为什么比架构更炸
比起架构,社交平台上讨论度更高的是价格。Flash 系列一向是 DeepSeek 用来打性价比的型号,这一档的 API 价格再下探,直接把多模态推理的门槛拉到了中小团队也能随手试的水平。
要注意的是,Flash 定位是“够用且便宜”,不是旗舰。对延迟敏感、对长推理链要求极高的任务,仍然要看更大的模型。把它理解成日常工作的默认引擎,比把它当成万能解更现实。
谁会立刻感受到变化
第一波受益的是文档类应用:发票识别、合同抽取、研报总结、论文图表问答,原本需要三四个模型的链路,现在可以在一次请求里完成。
第二波是内容创作工具。图文混排、配图解读、UI 草图转代码这类工作流,过去要么靠人工,要么靠昂贵的多模态 API。现在做 MVP 验证的成本明显下降。
第三波是企业内部知识库。把扫描件、截图、白板照片直接喂给模型,再让模型用中文结构化输出,是很多公司今年在尝试的方向。V4.1-Flash 的定价会让这类试点更容易走完第一阶段。
还不能急着下结论的地方
新架构在公开榜单上的表现、是否会在中文长文档理解上出现“看着懂、其实没懂”的幻觉,以及高并发下的稳定性,目前都还缺少独立验证。
另外,552B MoE 的部署门槛不低,本地化跑起来并不容易。对绝大多数中文用户来说,更现实的做法还是走 API,把省下来的钱花在提示词工程和评测上。
后续值得盯的几个点
一是 DeepSeek 是否会推出更小的视觉模型,把这一套原生多模态能力下沉到端侧或者消费级显卡上;二是社区里是否会出现基于 V4.1-Flash 的工作流模板,比如“一图一报告”“截图转结构化笔记”。
三是价格战会不会逼得国内其他大模型厂商提前调整 Flash 类产品的定价。对于普通 AI 工具使用者来说,这反而是一个更好的时间点去对比和迁移。
一句话:V4.1-Flash 这次把“多模态”和“便宜”这两件事绑在了一起。对于每天要和图文、截图、PDF 打交道的开发者、创作者和企业用户,这是一次值得立刻上手试一次的版本。
同主题阅读路径
查看「模型发布」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具