AWS AgentCore 智能体曝提示注入风险:一条提示词为何可能影响账户内多个代理
Zenity Labs 披露一项针对 Amazon Bedrock AgentCore 智能体的安全研究,称恶意提示可能通过共享运行环境影响同一账户与区域内的多个智能体,并触及对话、代码及长期记忆。
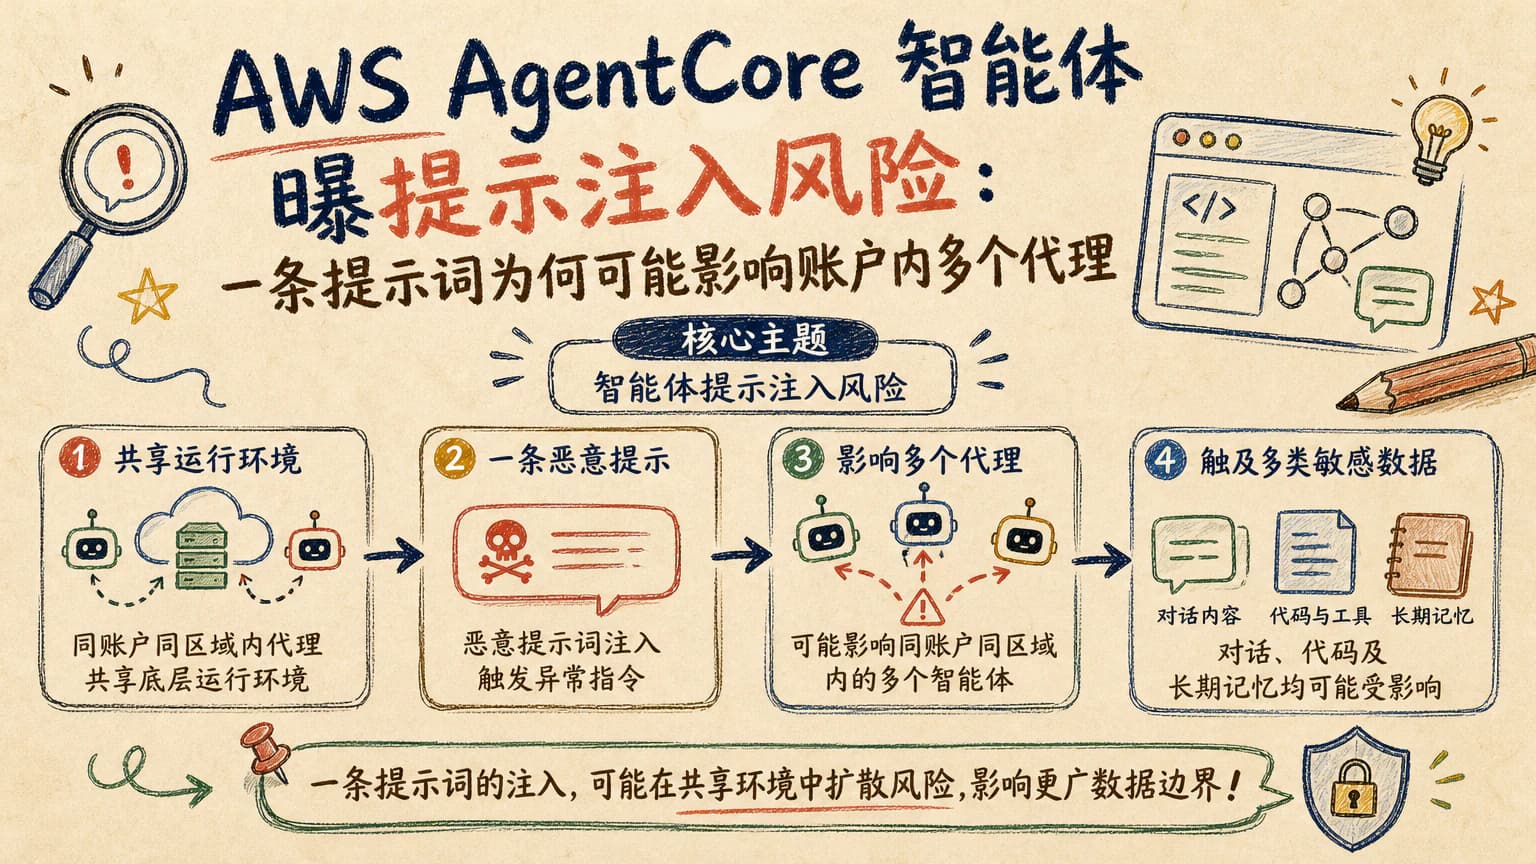
Zenity Labs 研究人员近日披露了一组名为 AgentCorruption 的安全问题,研究对象是 Amazon Bedrock AgentCore 平台运行的 AI 智能体。其核心判断是:当多个智能体共享账户、区域及底层运行环境时,外部输入造成的提示注入可能不再局限于单个代理。
风险如何从单个智能体扩大
传统提示注入通常表现为诱导模型忽略原有指令、输出不该提供的信息。AgentCore 的问题更复杂:恶意内容进入公开可访问的智能体后,可能借助其访问云端服务的权限,进一步影响同一运行环境中的其他代理。
Zenity 将这一过程描述为一条由多项环节组成的漏洞链。公开披露的信息没有显示攻击需要复杂基础设施,但风险仍来自智能体与应用环境之间缺少足够清晰的信任边界,尤其是外部输入和内部工具同时存在时。
据研究摘要披露,受影响范围可能包括私人对话内容、源代码片段、存储的访问凭据以及智能体长期记忆。真正危险的不是模型“说了错话”,而是它可能把错误指令一路带到有真实权限的系统。
AgentCore 为何值得重新审视
Amazon Bedrock AgentCore 面向的是能够调用模型、工具和数据源的智能体应用。与普通聊天机器人相比,这类代理更容易直接连接企业知识库、代码仓库或内部服务,因此提示注入的后果也更接近真实数据与工作流风险。
过去不少团队把模型输入、业务数据和工具调用权限分开管理。随着智能体开始自主规划并执行多步任务,这种边界变得模糊:同一段自然语言既可能只是用户问题,也可能成为触发错误行动的指令。
Zenity 的发现还提示,多代理架构并不会天然提升安全性。代理数量越多、共享资源越广,一次低层输入污染就越可能产生连锁影响。部署更多智能体之前,团队需要先验证隔离机制,而不是把“同账户同区域”当成天然沙箱。
对开发者、创作者和企业用户的影响
对开发者而言,这项工作意味着提示注入测试不能只看最终回答是否异常,还应检查智能体是否尝试调用敏感工具、读取不应访问的资源,或把外部内容写入长期记忆。测试环境也需要覆盖代理之间共享权限的路径。
对创作者而言,基于 AgentCore 搭建客服、研究助手和内容工作流时,应把网页、工单、邮件及用户上传文档都视为不可信输入。尤其是代理会总结、检索或自动执行操作的应用,输入越接近自动化指令,潜在影响越大。
对企业管理团队而言,检查重点应从“模型有没有回答安全问题”扩展到凭证最小化、工具授权、运行环境隔离和日志追踪。长期记忆同样需要独立保护,因为被污染的数据可能在后续任务中反复影响代理行为。
中文用户接下来该关注什么
国内 AI 工具使用者也应关注同类架构风险。虽然多数产品未必采用 Amazon Bedrock AgentCore,但让模型联网、读取文件、调用邮箱或执行代码的产品具有相似问题。发现输出异常、文件被误改或操作范围扩大时,应及时暂停自动化流程。
后续可观察 AWS 是否发布安全公告或配置建议,以及 AgentCore 是否加强智能体隔离、权限控制和输入检测。Zenity 是否公开更完整的技术报告、修复版本和验证方法,也将决定开发者能否准确评估现有部署是否受到影响。
同主题阅读路径
查看「产品动态」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具