GitHub 开源新项目让 AI 编程助手"记住"上下文:用 SSH 同步智能体记忆
一个面向编程 AI 智能体的开源记忆项目在 GitHub 发布,支持通过 SSH 同步记忆数据,可自托管、无需依赖特定云服务。它瞄准的是 AI 编码助手跨会话失忆的痛点,对个人开发者和团队都值得一看。
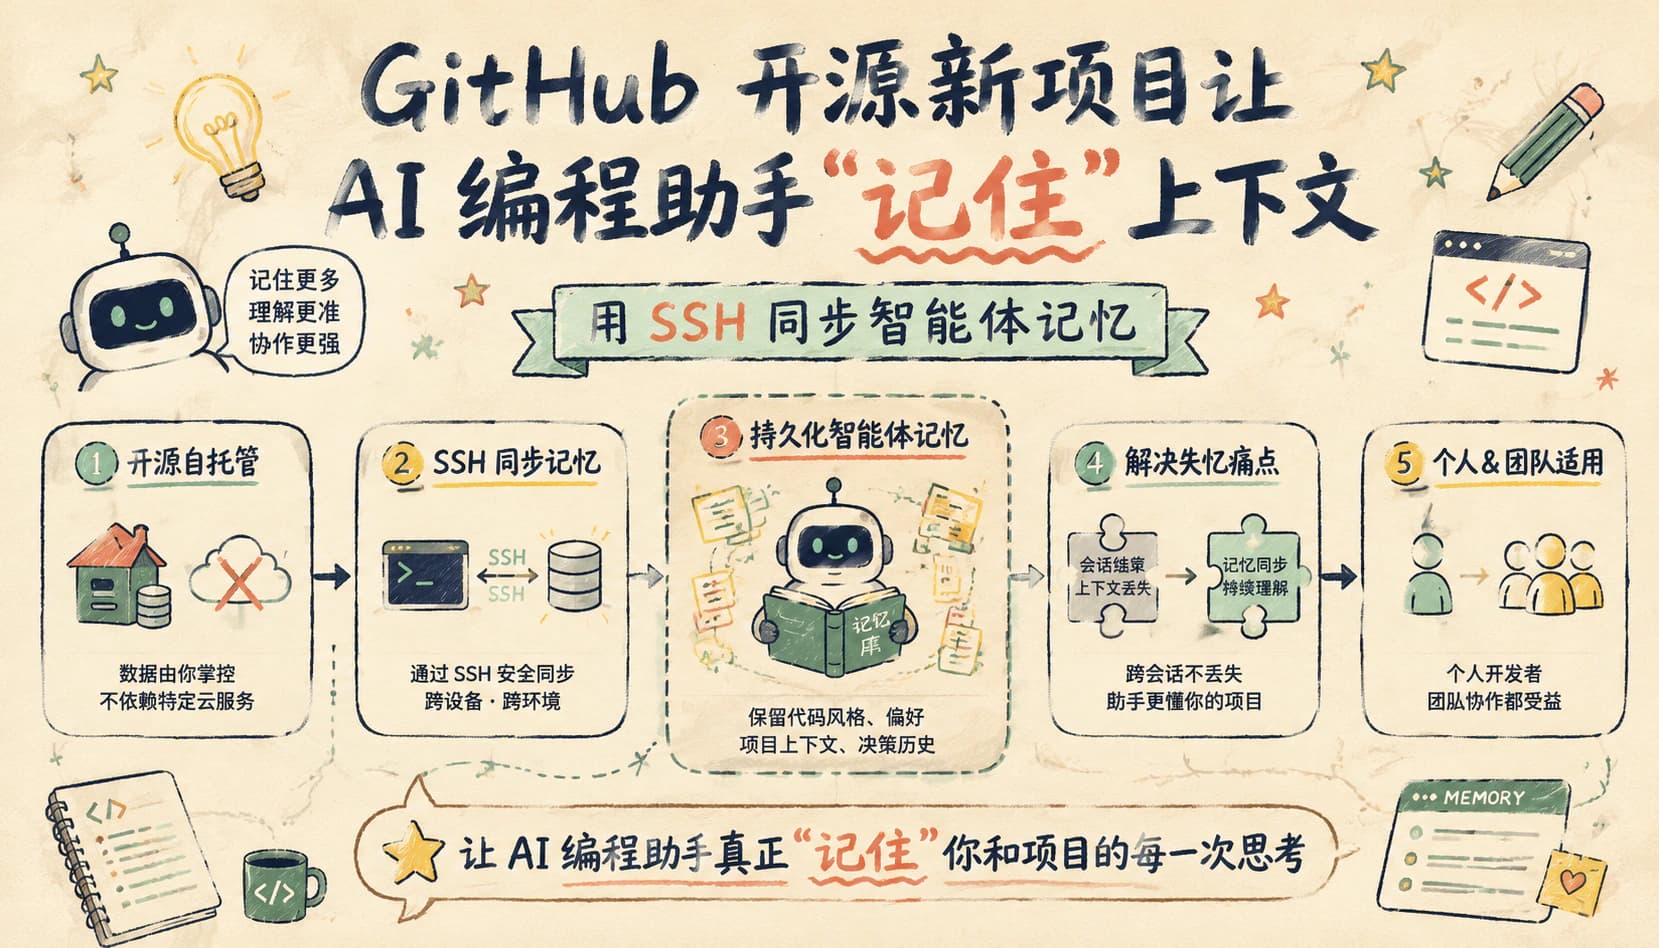
近日,一个名为 Deja Vu 的开源项目在 GitHub 发布,定位很直接:给编程 AI 智能体装一套“长期记忆”,并允许通过 SSH 在多台机器之间同步记忆数据。项目由开发者 vshulcz 公开,全部代码托管在 GitHub,采用自托管模式,不绑定任何云服务。
这套方案的核心思路并不复杂。AI 编程智能体在多轮交互中往往只能记住当前会话上下文,一旦关闭终端或切换设备,之前积累的项目背景、调试记录、约定俗成的代码规范就全部归零。Deja Vu 希望把智能体与人类协同时产生的有用信息沉淀下来,并在下一次会话中重新加载。
为什么“记忆”是编程智能体的短板
过去一年,主流 AI 编程工具在单次会话内的表现已经相当稳定,但跨会话能力始终是个软肋。一名开发者今天让智能体梳理完项目结构、约定好命名规则,第二天再开新会话时,这些信息又得重复交代。Deja Vu 这类项目的目标,就是让智能体像资深搭档一样记住项目细节,而不是每次都从零开始。
从公开信息看,Deja Vu 的记忆数据存放在本地,跨设备同步走的是 SSH 通道。这意味着用户可以把它部署到自己的服务器、家用 NAS,甚至跳板机后面,而不必担心数据流向第三方平台。
SSH 同步的取舍
选择 SSH 而不是云端 API 的好处很明显:链路可控、加密原生、不依赖特定厂商。但代价也有——同步拓扑相对原始,跨网络环境的稳定性需要用户自己保障。如果你日常开发环境固定在一两台设备之间,体验会很顺;如果要在笔记本、台式机、远程开发机之间频繁切换,则需要提前把同步策略想清楚。
对个人开发者来说,Deja Vu 的意义在于“可折腾”。它不是开箱即用的 SaaS,而是一套需要按项目情况调优的工具。这既是一种门槛,也是一种自由。
对企业团队而言,自托管 + SSH 的组合意味着记忆数据可以完全留在内网。这在涉及未发布代码、敏感业务逻辑的项目里,是非常实际的合规优势。代价是运维成本,谁来跑、怎么备份、怎么监控,都得有人管。
对中文开发者的实际意义
如果你已经在用 Cursor、Claude Code、Continue、Cline 这类编程智能体,可以把 Deja Vu 当作外挂层。它本身不替代模型,而是为这些智能体补一块“长期记忆”。中文项目里的命名习惯、注释风格、模块拆分逻辑,往往和英文项目差别不小,这种细颗粒度的上下文恰恰是当前主流模型最容易丢的部分。
需要提醒的是,记忆越完整,泄露面也越大。团队内部署时,建议把记忆内容做成分级,普通项目级信息可以全量同步,涉及密钥、客户数据、商业策略的部分应当明确隔离,避免被无意间写进共享记忆。
后续值得关注的几个方向
第一,社区会不会出现更友好的部署方案,比如 Docker 一键起,或对接主流 IDE 插件。第二,记忆格式是否标准化,避免被锁定在某一个项目里。第三,是否会出现基于本地向量库的语义检索,让记忆真正“懂”项目而不是简单回放历史文本。
对于关注 AI 编程工具的中文用户,Deja Vu 提供了一个观察窗口:智能体的下一阶段竞争,很可能从“谁更聪明”转向“谁记得更久”。开源 + 自托管的路线,短期不会取代商业产品,但它会让大公司不得不认真回应“数据归属”这个问题。
同主题阅读路径
查看「产品动态」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具