微软发布 AI 生物研究系统 Quine:把"世界模型"放进细胞和蛋白质里
微软研究院推出 Quine,一个面向生物学复杂性的 AI 研究系统。它把基因组、蛋白质、化学和细胞状态塞进同一个世界模型里,并配套开放 Quine Fellows 项目,让外部研究者也能上手试用。
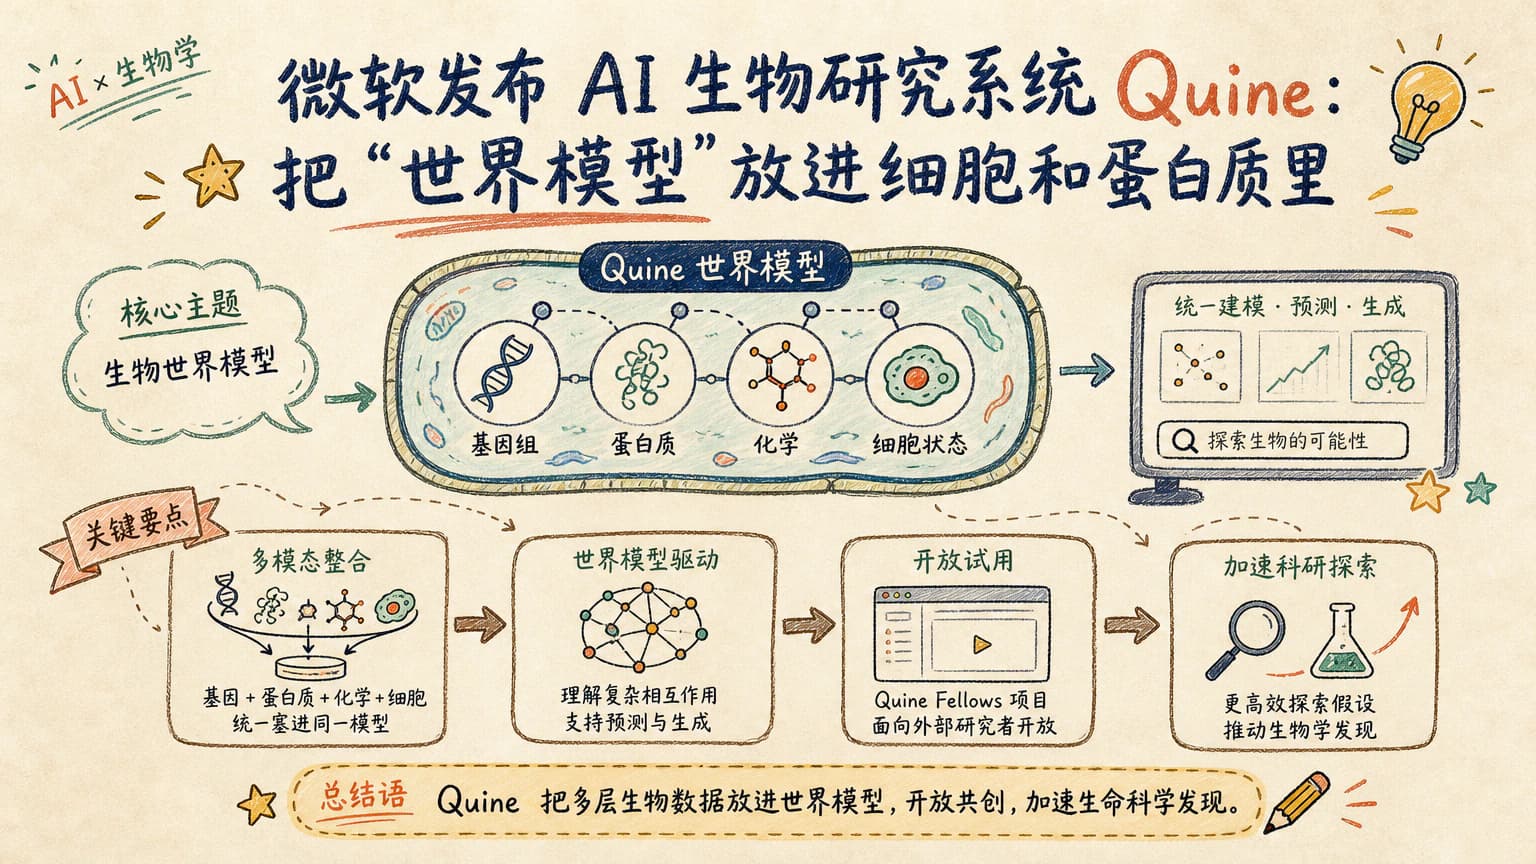
最近微软研究院上线了一个面向生命科学的 AI 系统 Quine,主打"生物学世界模型"。和普通生成式模型不同,它试图在同一空间里联合学习基因组、蛋白质、化学分子、细胞状态和生物成像,再推理"如果我施加某种干预,会发生什么"。对生物 AI 圈来说,这是一个从"识别模式"走向"模拟系统"的明显信号。
Quine 到底在做什么
传统生物 AI 工具大多是单模态的:一个模型看序列,一个看结构,一个看图像,输出再由研究者人工拼接。Quine 的卖点是把这些模态放进同一个底层表示,并配套一个交互式 harness,让研究者可以像写代码一样调用它来提出假设、跑反事实推理。
微软研究院在博客里强调,Quine 不是替代湿实验室的工具,而是"把假设生成前移到桌面"的协作层。它的输出会带出处和置信度,提示哪些结论还需要做实验验证。这降低了日常科研流程中对单一模型的过度依赖。
为什么是"世界模型"路线
过去两年,大模型领域的一个明显分歧是:通用大模型到底该不该继续堆参数,还是应该向"能模拟物理和生物世界的系统"靠拢。Quine 更像后者,它把生物系统当成一个可计算的对象。
这种路线对长尾、低数据的科研任务更友好,因为研究者可以直接问"如果改变这个启动子会怎样",而不必为每种条件单独收集训练样本。对国内做合成生物学、蛋白设计和药物发现的团队而言,这种范式比单纯刷榜更有工程价值。
Quine Fellows 同步开放
和系统一同上线的是 Quine Fellows 项目,对外部研究者开放申请。被选中的研究者可以获得算力、API 配额,以及和微软研究院团队一起迭代模型的机会。
这意味着 Quine 不是封闭的内部项目,而是微软在生物 AI 领域设置的一个长期接触点。比起一次性发布 demo,这种"研究员驻场"模式更容易暴露真实场景里的边界条件,比如数据噪声、批次效应、可重复性问题。
对国内开发者和企业用户的实际影响
短期内,国内用户不太可能直接调用 Quine 的完整 API,但它的设计思路完全可以借鉴:把多模态数据融合进一个统一表示,给研究者留出可干预的接口,而不是只给一个黑箱聊天框。
对做蛋白设计、酶工程、合成生物路线优化的团队来说,可以开始评估类似架构是否值得自建;对 AI 工具使用者来说,则可以关注 Quine 在"假设生成"环节的表现,看看它是否能替代部分人工文献综述。
中文用户应该关注什么
第一,看 Quine 在可重复性上的表现。生物 AI 最大的痛点不是预测不准,而是换一批数据结果就崩。第二,关注它对"非编码区、调控元件"这些过去被忽视的序列的处理能力,这才是世界模型真正的试金石。第三,留意微软是否会逐步把 Quine 拆出独立模块,让第三方工作流接入。
后续值得观察的点
短期内有几个明确问题:Quine 在多大程度上会公开预训练数据清单、benchmark 细节和失败案例?它对中文生物文献和中文生命科学数据库的覆盖够不够?以及它和 AlphaFold、ESM 系列等已有蛋白模型是互补还是重叠?
对国内机构而言,更现实的动作不是等 API,而是把 Quine 当成参照系:在自己的数据上试一试同等的多模态联合学习是否值得投入。这是它给中文 AI 圈留下的最有用的提示。
同主题阅读路径
查看「模型发布」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具