xAI Grok Build CLI 默认上传整个仓库代码与 git 历史,关闭"改进模型"为什么无效?
安全研究者抓包发现 xAI 的 Grok Build 编码 CLI(0.2.93)默认把整个仓库文件、git 历史、.env 密钥明文上传至 Google Cloud Storage,关闭"改进模型"开关也无效。12 GB 仓库测试中上传通道传输 5.10 GiB 数据,约为对话通道的 2.78 万倍。
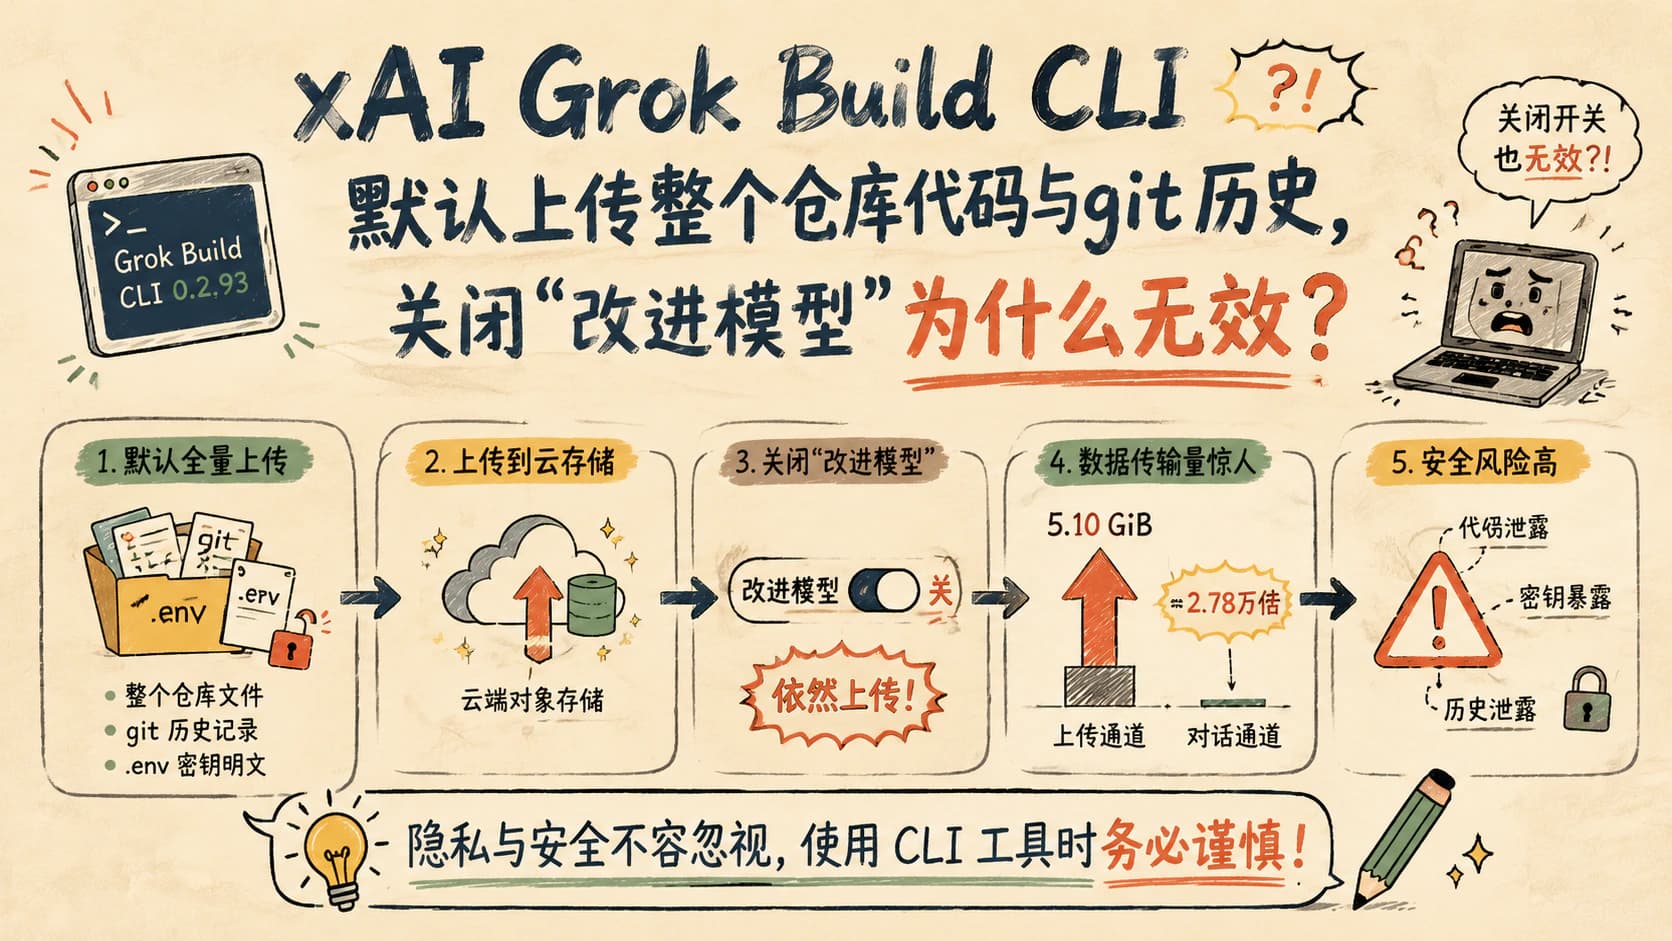
事件概述最近有人对 xAI 官方推出的 Grok Build 编码命令行工具(grok 0.2.93)做了完整网络抓包。结论比较硬:这个面向消费者的工具,在你登录后会把仓库里的东西几乎原样搬走,远不止"你跟 AI 的对话"那么多。
三类数据被打包上传抓包分析显示,Grok CLI 会向 xAI 发送三类东西。第一类是它读取到的文件内容,包括常见的 .env 密钥文件,以明文 POST 到 /v1/responses;同时会被二次打包成 session_state 存档,通过 /v1/storage 上传,并收到 HTTP 200 确认。
第二类是整个仓库的全部文件加上完整的 git 历史。注意,是"全部",不取决于 AI 智能体实际读过哪些。研究者在 prompt 里明确写了"不要读取任何文件",Grok 依然把内容作为 git bundle 上传到 Google Cloud Storage 的 grok-code-session-traces 存储桶。
第三类是上传机制本身默认开启,并且关闭"改进模型"开关并不会真正禁用——/v1/settings 接口仍然返回 trace_upload_enabled: true。
测试用的仓库 12 GB,/v1/storage 通道传了 5.10 GiB 数据,而模型对话通道只传了 192 KB。两者比例大约是 27,800 倍。换句话说,你跟 Grok 说一句话,它往云端搬的体积相当于这句话的几万倍。
对开发者和企业的实际影响过去几个月,xAI 把 Grok 从聊天机器人扩展到编码助手,正面对标 Claude Code、Cursor 这类产品。消费者版登录门槛低、上手快,但底层数据传输对普通用户几乎是黑盒。这次抓包的价值,就是把黑盒变成了具体数字。
如果你的 .env、API Key、数据库连接串直接落在工作目录里,这些内容很可能已经被以明文形式外传。即便密钥写在 .gitignore 里,只要文件存在于本地、Grok 进程能扫到,仍然有风险。
对企业团队来说,更敏感的是内部代码、未公开的客户项目、还在保密阶段的算法,可能在员工不知情的情况下进入第三方对象存储。这是合规层面的事,不是技术爱好者的小问题。
短期内最稳妥的做法,是把 Grok Build 限定在不含敏感信息的练习项目里;正式业务代码先用其他本地化或企业版的 AI 工具顶着。把生产环境的 .env、配置文件、客户数据从工作目录物理隔离,是最直接、成本最低的防线。
还没回答的问题分析没有直接证明 xAI 会拿这些数据训练模型,但数据被传输、被接收、被存储这三件事已经被证实。下一步值得看的是:xAI 是否正式回应、是否会调整默认行为,以及其他 AI 编码工具会不会被同样方式拆开。
另外,整仓库上传的设计动机本身也值得追问——是出于调试需要、模型微调,还是单纯的产品决策?这些细节会决定开发者要不要继续把它放进日常工作流。
相关背景与后续阅读
本页本轮复核重点:突出代码仓库、Git 历史和模型训练选项之间的数据风险。
- MiniMax Code 桌面端 2.0:继续跟踪桌面编码代理的产品路线
- Railway 获得 1 亿美元推进 AI 原生云:理解 AI 开发工具背后的部署平台竞争
编辑复核说明:本页把已公开事实与编辑分析分开呈现;事件后续、产品能力和商业条款可能变化,请结合原始来源核对。
同主题阅读路径
查看「模型发布」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具