通义 Qwen-Audio-3.0-Realtime 上线,实时语音推理榜超过 OpenAI
阿里通义实验室推出实时语音交互模型 Qwen-Audio-3.0-Realtime,在 Artificial Analysis 语音推理子项中拿下综合第一,超过 GPT-Realtime-2。国产语音模型正在把差距拉开。
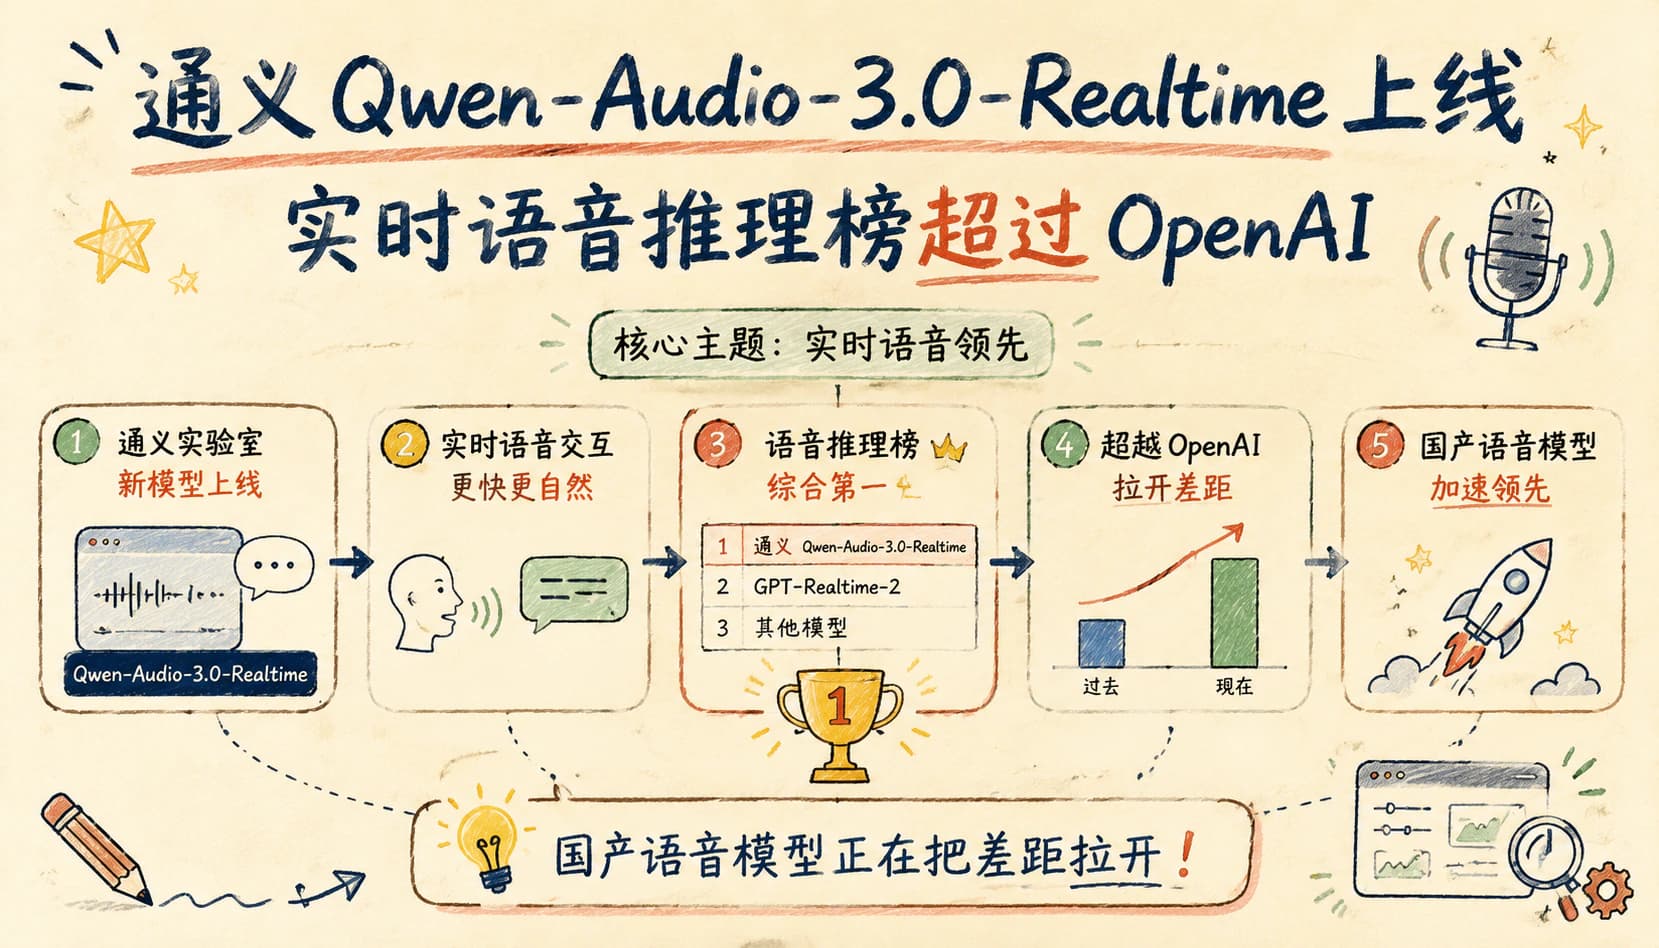
阿里通义实验室正式发布实时语音交互模型 Qwen-Audio-3.0-Realtime,并在国际评测平台 Artificial Analysis 的 Speech Reasoning(语音推理)子项中拿下综合排名第一。榜单显示,该模型超越了 OpenAI 的 GPT-Realtime-2,成为该子项当前的头名选手。
这条消息来自通义实验室的官方公众号,发布节点紧贴在模型上线之后。Artificial Analysis 是业内被引用较多的第三方模型评测平台,按子项拆解语音、数学、代码等维度,常被海外开发者用作选型参考。
通义实验室的 Qwen 系列已经从最初的文本大模型,扩展到代码、视觉、多模态和 Agent 方向。这次发布的实时语音模型,可以看作是其多模态版图里「语音」这一块的关键补齐。
Speech Reasoning 到底在测什么
语音推理不等于普通的语音识别或语音合成。它更接近让模型在听到一段带逻辑链的对话后,能理解其中因果、隐含意图和上下文关系,并给出有判断力的回应——比如听懂对方在反问、在暗示,还是在要求模型做多步推演。
把这一项单列出来,意味着评测方认为「能不能思考」已经比「听不听得清」更重要。对中文场景来说,这种评测价值更高,因为中文里的反问、留白和语气词往往承担逻辑信号。
实时语音为什么是下一个战场
过去一年,语音 AI 的焦点从「能不能生成自然音色」转向「能不能像人一样对话」。实时语音的关键参数不只是延迟数字,而是模型能否在被打断、被反问、被要求换话题时保持上下文不掉链。
OpenAI 的 GPT-Realtime 系列和 Google 的 Gemini Live 都在抢同一块蛋糕——把语音做成一个可直接对话的产品入口,而不是 TTS 加文本模型的拼接。千问此次上榜,说明国产阵营也进入了同一阶段。
对开发者和企业用户的实际影响
对国内开发者而言,多了一个可对比的中文原生实时语音选项。Qwen 系列此前已在开源社区积累了较高的二次开发量,实时语音一旦开放 API 或开源权重,做客服、车载、陪伴、教育口语陪练等场景的团队会优先评估。
对企业用户来说,更直接的意义在于成本和合规。国产模型在国内部署有数据合规优势,而语音推理能力如果真的追平甚至超越海外旗舰,本地化方案的「能力打折」问题会显著缩小。
后续值得观察的几件事
接下来要看的不是单一榜单名次,而是三件事:其一,模型是否开放 API 或开源,是否附带端侧版本;其二,在中文长对话、噪音环境、多人交谈等真实场景中的实际表现;其三,定价是否覆盖从个人开发者到大客户的完整区间。
另一个值得跟踪的细节,是 Artificial Analysis 本身是否会调整评测口径。任何榜单都有生命周期,榜单只是参考,开发者最终还是要按自己的业务场景做盲测,而不是照抄名次。
总体来看,这次上榜更像是一个信号:实时语音 AI 已经从「能不能做」走到「谁做得更好」的阶段,国产品牌开始具备和海外旗舰正面比较的资格。对中文用户来说,好消息是选择变多了,竞争本身也会让 API 价格更合理。
同主题阅读路径
查看「模型发布」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具