MiniMax Music 3.0 开源:五分钟一首歌,AI 音乐生成进入"生产级"赛道
MiniMax 推出 Music 3.0,开放模型权重,支持最长五分钟的全流程音乐生成。这意味着从作曲到编曲再到混音,AI 可以一次性完成。开源策略让中小开发者和内容创作者首次拿到接近商用水平的音乐模型。
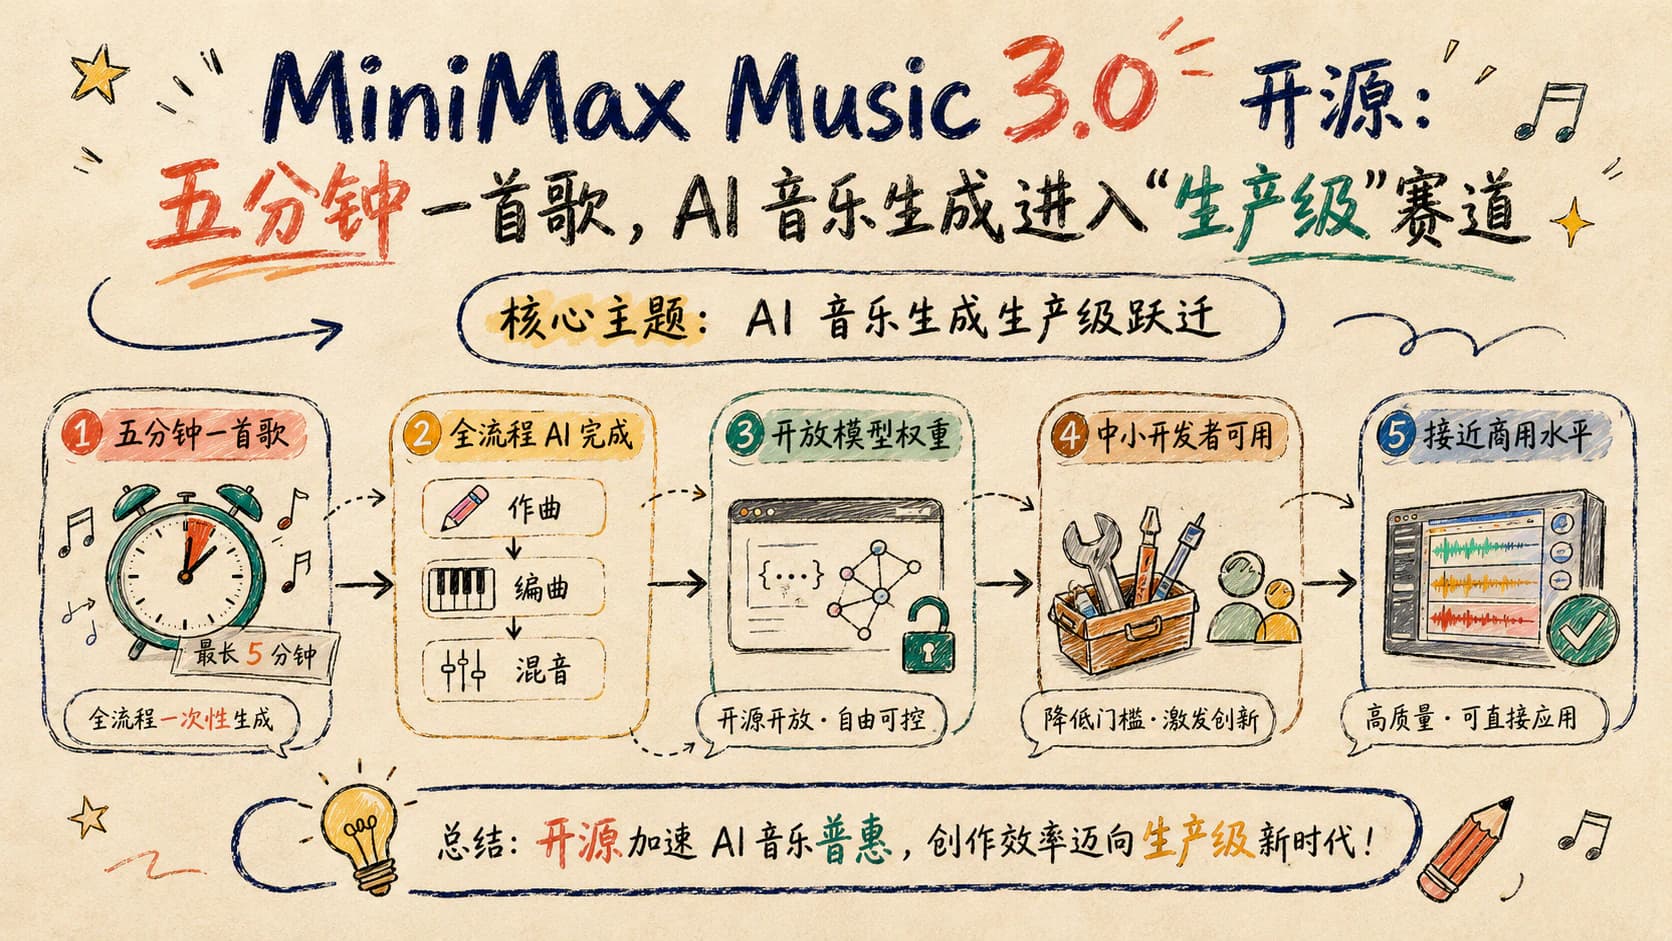
MiniMax 正式发布 Music 3.0,这是一个面向生产环境设计的开源音乐生成模型。用户只需要给出一段创意概念,或者一段歌词加上风格提示,模型就能一次性输出整首歌的作曲、编曲、演奏和制作成品。
和上一代相比,Music 3.0 最直观的变化是长度。模型现在可以生成长达五分钟的完整作品,覆盖主歌、副歌、间奏和尾声的完整结构,对流行、摇滚、电子等不同风格都有支持。
这次发布的核心卖点是“全能”。模型可以自动决定乐器配置、和声走向和人声表达,输出可以直接进入后期混音流程,省掉了大量中间环节。
技术亮点
音乐和语言不同,分钟级输出需要处理的时间跨度更大,对模型的记忆与连贯性要求更高。Music 3.0 在架构上对长序列生成做了专门优化,目标是让五分钟的曲子听起来像一首完整作品,而不是几个片段的拼接。
人声演唱的处理也更细致,覆盖咬字、气息感和情感起伏。这意味着同一段歌词,在不同的情绪提示词下,可以产出差异明显的演唱版本,适配抒情、摇滚、电子等不同场景。
编曲层不再是简单的背景垫音,而是可以承担段落过渡和情绪推进的角色。整首曲子的层次因此更接近真实乐队的演出结构,听感上比前代更立体。
对开发者和创作者的实际意义
对独立音乐人和内容创作者来说,最直接的收益是效率门槛的进一步降低。做一首 Demo 从“找编曲、等混音”压缩到“写一段提示词”,单人就能跑通从灵感到成品的链路。
对应用开发者而言,Music 3.0 采用开源权重,可以本地部署、微调,或接入到自家产品。这对做短视频工具、播客平台、游戏音效、广告素材的团队尤其有吸引力。
企业用户可以把它嵌入到内部内容流水线,例如电商平台的商品视频配乐、社交平台的 UGC 背景音乐生成。这类场景对成本敏感、对质量要求逐年提高,开源模型正好提供了可控的选项。
中文用户要留意什么
音乐生成模型的中文演唱能力一直是关注点。Music 3.0 在英文演唱上明显更成熟,中文表现需要实测才能判断,包括发音准确度、节奏感和咬字自然度。
同时,开源权重不等于可以直接商用,使用前要看清许可证条款,特别是涉及商用、再分发和模型微调的具体限制,避免后续踩坑。
后续值得观察的方向包括:社区微调版本什么时候出现、人声替换和风格克隆的边界在哪里,以及长音频生成是否会进一步突破十分钟。这些问题的答案,会决定 Music 3.0 能走多远。
同主题阅读路径
查看「模型发布」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具