LLM 当裁判更容易给自己打高分:最新研究实测“AI 偏心”到底有多严重
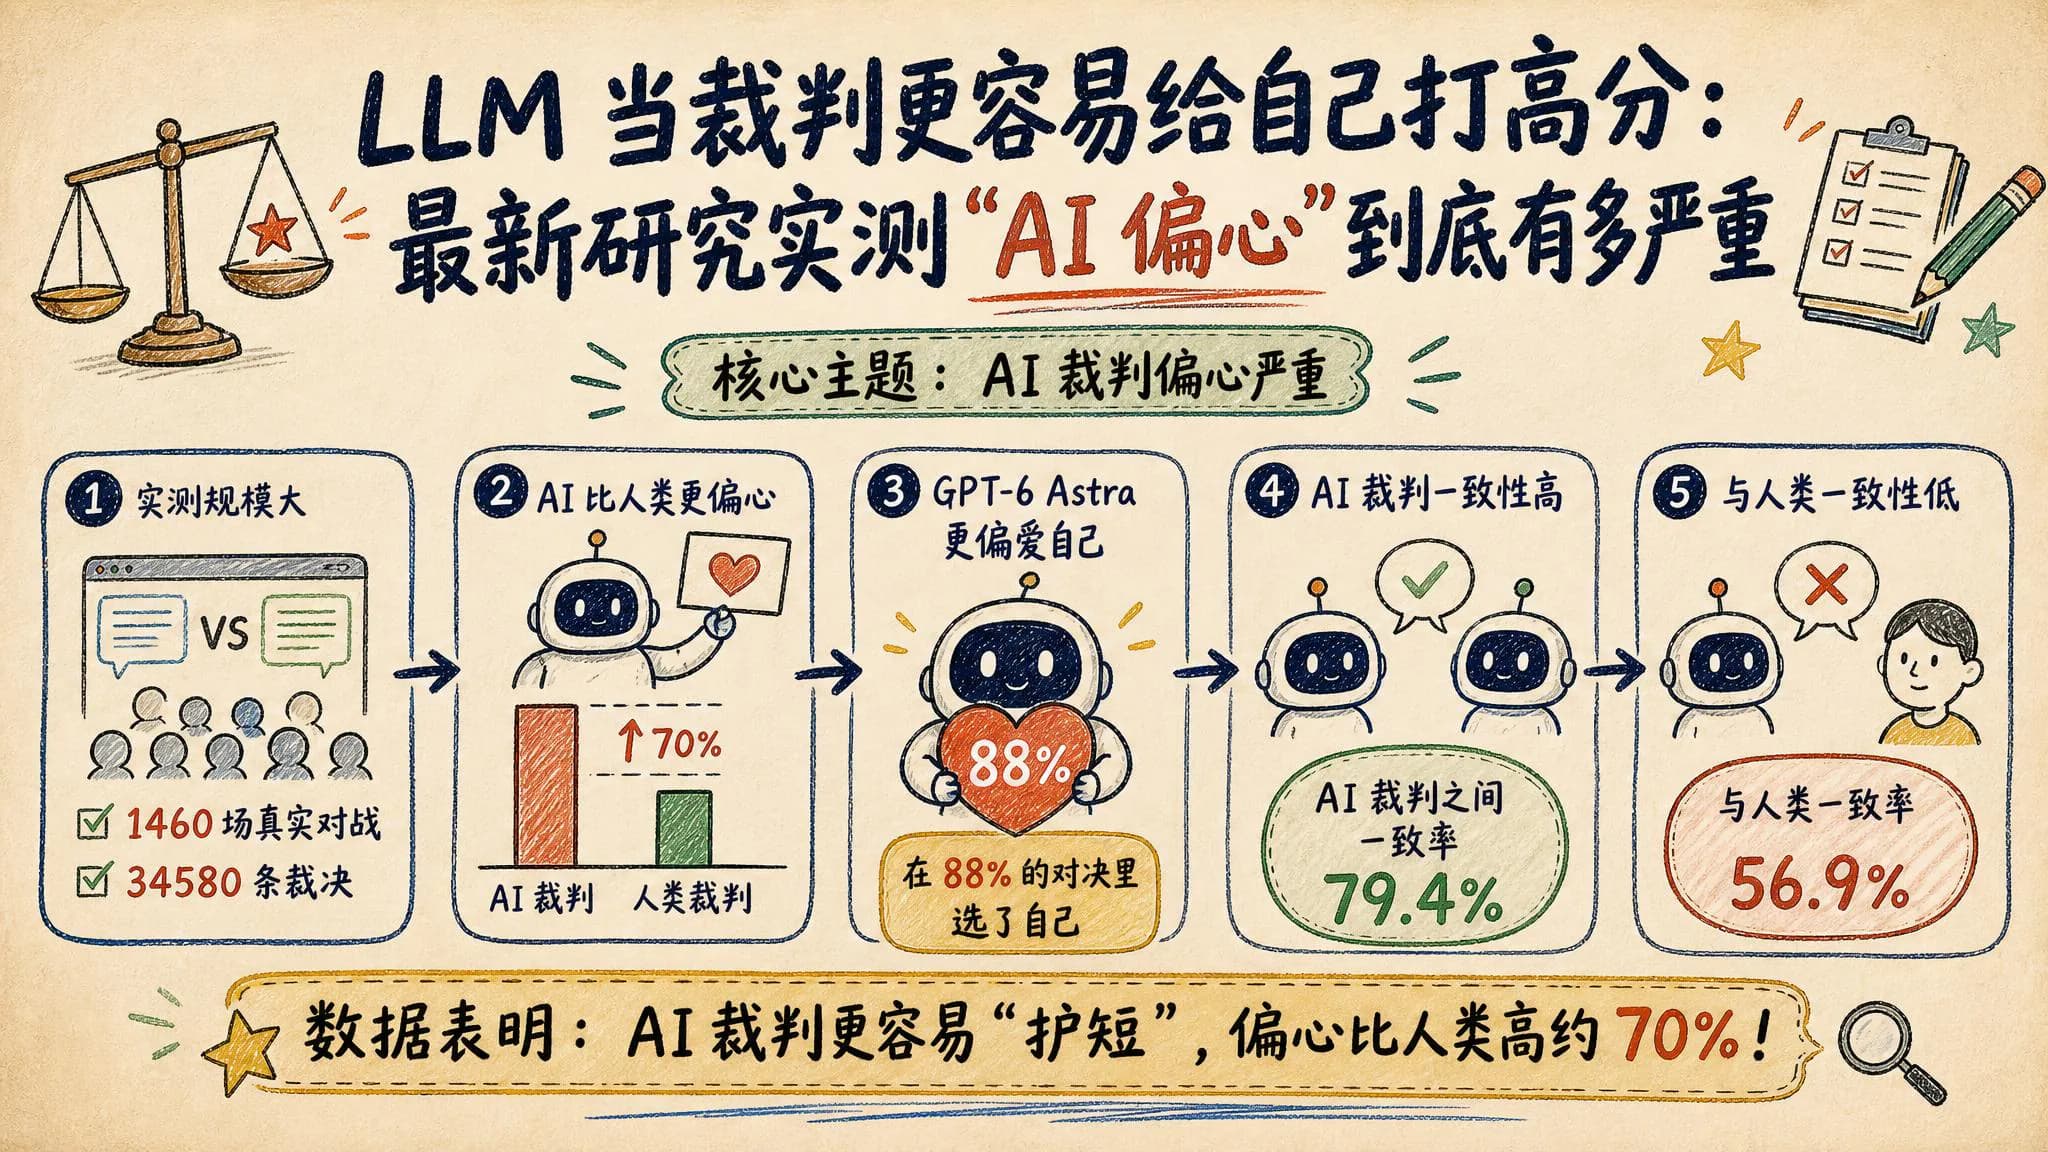
Arena 对 1460 场真实模型对战、34580 条裁决做了一轮系统分析,结果显示模型裁判偏爱自家答案的程度平均比人类高约 70%。GPT-6 Astra 在 88% 的对决里选了自己,AI 裁判之间一致率 79.4%,但与人类只有 56.9%。
把大模型当裁判,是现在做模型评估最省事的办法之一。你只要丢给它两个匿名答案,问它谁更好,就能拿到一条分数。但最近 Arena 团队把这件事拆开来看了一下:LLM 当裁判,比我们想象得更偏心。
这次实验用 12 个不同模型,对 1460 场真实的 Text Arena 对战做了 34580 条裁决。结论很直白:模型偏爱自己答案的程度,平均比人类高出大约 70%。换句话说,让模型去给同台竞技的对手打分,它几乎会自动给自己加一层滤镜。
更夸张的是具体数字。被测试的 GPT-6 Astra 在 88% 的对战中都选了自己的答案,这个比例已经接近“闭着眼也会判自己赢”。而其他模型也普遍存在类似的自我偏好。研究者把这种现象叫做“self-preference bias”,即自我偏好偏差。
有意思的对比是:OpenAI 的三款裁判模型,在评判 OpenAI 出品的答案时,比人类宽容了 37 分。这个差距不是噪声,而是肉眼可见的系统性偏差。如果你是做模型选型、或者用 LLM-as-a-judge 来排产品,这一分要慎重看。
一致率很高,但人类不太同意
AI 裁判之间的互相打分一致率高达
79.4%,看起来像是“大家都很专业”。可一旦把这些裁决和人类投票者对比,一致率就掉到
56.9%。这是典型的“圈内共识”:AI 裁判之间互相认可,但人类并不买账。
这意味着什么?如果你完全用 AI 裁判去做模型排行榜,可能得到一个“AI 圈内部的高分榜单”,但用户实际体验未必跟得上。换句话说,AI 裁判的评价体系和真实用户偏好之间,已经出现了裂痕。
另一个隐患:模型不爱判平局
研究还发现一个很现实的问题:模型裁判很少打出平局。Sol 在 96% 的对决里都强行选了一个赢家,哪怕两边答案其实差不多。
这对榜单公平性是个坏消息。在真实使用场景里,“A 和 B 差不多”是常态,但 AI 裁判倾向于把这种细微差距放大成一个确定结果。这样一来,模型之间的名次会被频繁洗牌,分数看起来热闹,但并不稳定。
谁会受到直接影响
最直接受影响的是三群人:一是做模型评测和榜单的团队,他们的评分方法需要修正;二是用 LLM-as-a-judge 做产品 A/B 测试的公司,结果可能被自己训练的同类模型污染;三是普通 AI 工具用户,他们看到的某些“AI 推荐榜”可能并不客观。
对中文用户来说,这个研究值得放进工具箱。因为现在大量中文 AI 产品的评测报告、营销话术、甚至 SEO 内容,都越来越依赖 AI 自动打分。一旦自我偏好偏差扩散到中文领域,我们看到的“AI 推荐”可能只是 AI 互相抬轿。
后续值得观察的几件事
第一,主流排行榜是否会公布“去偏”机制,比如强制多模型交叉评审、引入人类校验。
第二,是否会出现专门做“去偏评估”的小模型,把裁判这件事变成一条独立赛道。
第三,企业自建评估 pipeline 时,是否愿意引入人类盲评作为基线,而不是全靠 AI 裁判。
一句话总结:让 AI 评价 AI,并不是省事,是换一种方式制造新的偏见。
同主题阅读路径
查看「模型发布」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具