Anthropic 联手 Andon Labs 推 Drone-Bench:用仿真考 AI 操控无人机找人
Anthropic 与 Andon Labs 推出 Drone-Bench 评测基准,把室内定位追踪拆成五个子任务,通过软件复现评估 AI 模型自主操控无人机能力,足以区分不同智能水平的模型。
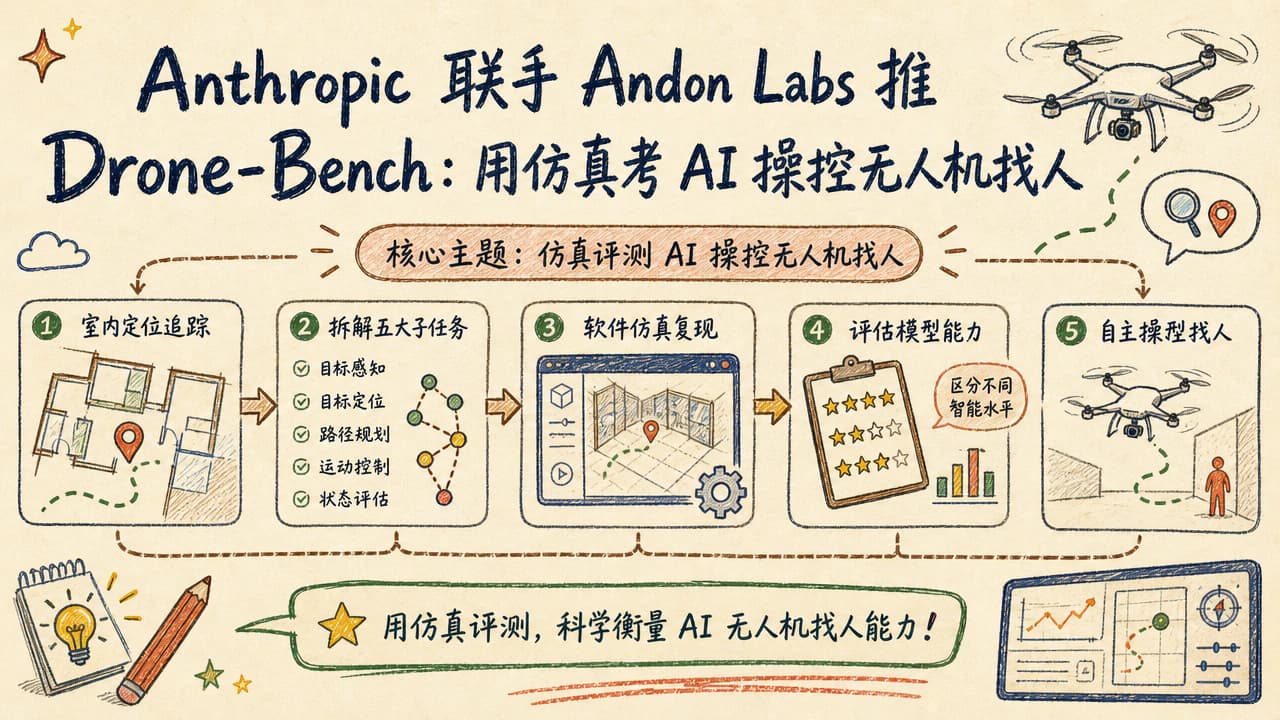
Anthropic 最近和机器人实验室 Andon Labs 联合推出了一项名为 Drone-Bench 的评测基准,专门用来考察 AI 模型自主操控四旋翼无人机、在室内环境里找人并跟随目标的能力。这是大模型研究里比较少见的、从纯文本和视觉测评走向真实物理操控的尝试。
把“飞无人机”拆成五道关
Drone-Bench 没有一上来就让模型直接飞。设计者把任务拆成了五个子环节:3D 地图重建、定位、导航、目标检测和跟随。每一步都有可量化的指标,分开打分。
拆环节的好处是,开发者能清楚地看到模型到底在哪一步卡住:是看不懂空间结构,还是找到了人却跟丢了。这种细粒度比单纯给一个“成功率”更有诊断价值,也方便后续针对短板做专门训练。
为什么要做这件事
过去几年,主流的大模型评测集中在写代码、做数学题、回答知识问答上。但能不能把这些能力迁移到真实环境里操控硬件,始终是个问号。Drone-Bench 想回答的就是:在“物理世界”这一关,AI 现在到底走到哪一步了。
选无人机是经过考量的。它体积小、室内可控,又同时考验感知、决策和实时控制——一条链上同时跑多个能力,比单点测试更能暴露模型的综合短板。
怎么做到“快速评估”
Drone-Bench 并没有要求每个团队真的去搭一台无人机。Andon Labs 提供了一套软件复现环境:模型发出指令,仿真里的飞控系统执行,研究者可以在几小时内跑完大量任务。
这种“软硬解耦”的思路并不陌生,自动驾驶领域的 CARLA、机器人领域的 MuJoCo 走的都是同一条路:先把评测基础设施做扎实,再让模型来刷分。Anthropic 在博客中提到,目前的实验已经能看出不同模型在这一任务链上出现了明显的能力分层。
对开发者和企业意味着什么
如果你做的是机器人、AR 或者智能硬件相关的产品,Drone-Bench 提供了一个新的对照坐标:不再只看模型在聊天和写代码上的分数,而是看它能不能在连续空间里完成一连串动作。
对企业用户来说,更现实的信号是——AI 正在从“回答问题”走向“执行动作”。一旦评测工具成熟,相关的智能体、具身 AI、自动化执行类产品会更快进入工程化阶段,而不是停留在演示视频里。
后续值得看的几个点
接下来值得观察的是:这套基准会不会被第三方独立复现、Andon Labs 是否会扩大仿真环境的复杂度、以及 Anthropic 自己的模型在这一项上的表现是否会作为官方参考线公布。
评测本身只是起点。真正的考验是当模型从仿真走向真实房屋、真实人群时,能力会不会大幅缩水——这也是所有具身 AI 项目必须面对的一关。
同主题阅读路径
查看「模型发布」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具