腾讯混元开源 AngelSpec 投机解码框架:端到端加速可达 2.4 倍
腾讯混元开源端到端投机解码框架 AngelSpec,在 Hy3-A21B 上实现 1.98–2.40 倍加速,吞吐量比 DFlash 高 10.5–11.8%,训练代码与草稿模型权重一并放出。
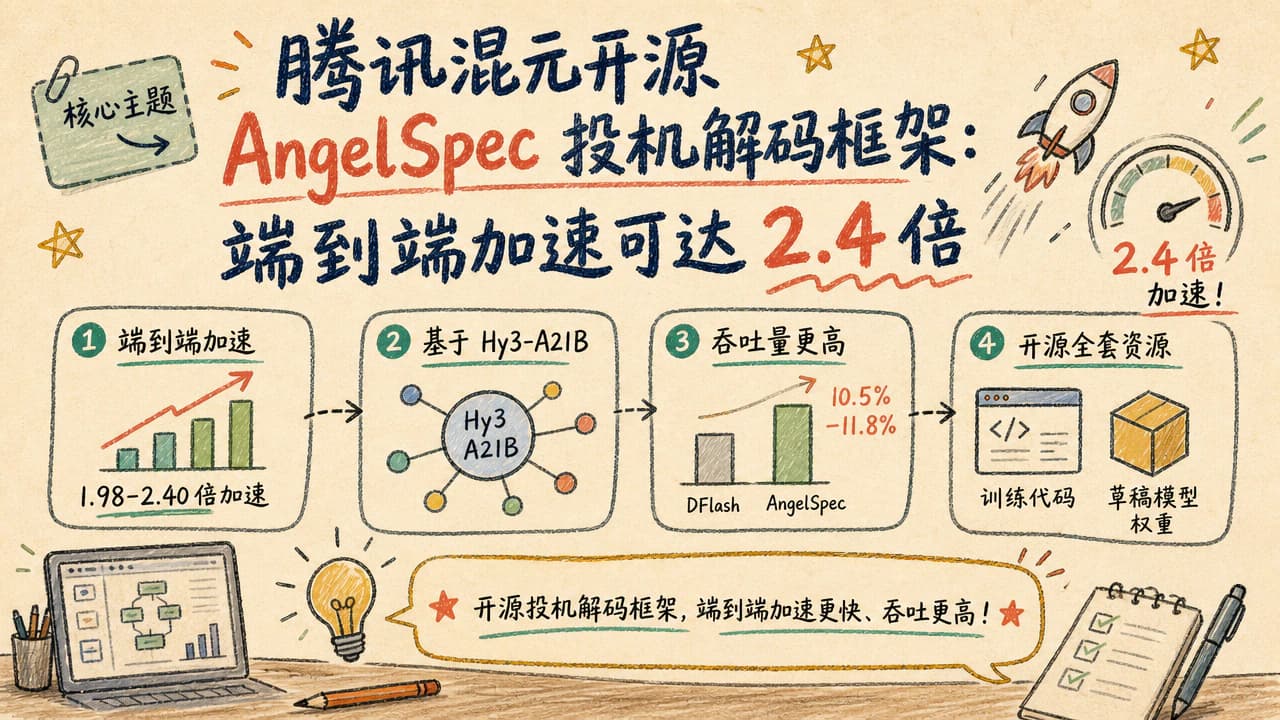
腾讯混元此次开源的 AngelSpec,是一套覆盖训练与部署的端到端投机解码框架。核心不是再造一个聊天模型,而是改善大模型逐词生成时的等待问题。
传统自回归解码需要按顺序生成令牌,模型难以充分利用并行计算。投机解码先让较轻的草稿模型提出候选,再由目标模型集中验证可用部分,思路类似“先起草、后校验”,但会增加一层系统调度。
按混元公布的数据,在 Hy3-A21B 模型上,DFly 方案相较自回归解码取得
1.98 至
2.40 倍端到端加速;与 DFlash 相比,吞吐量高出
10.5% 至
11.8%。这些数字指向同一目标:减少等待,提高生成效率。
开源重点不止是加速
此次开放内容不只包括 AngelSpec 训练代码,也包含 Hy3-A21B 的 MTP 与 DFly 草稿模型权重。对希望复现实验、调整训练流程或搭建服务的研究者而言,“框架加权重”比只放概念或接口更接近可验证交付。
MTP 通常服务于多令牌预测,让模型一次准备多个后续候选;草稿权重则负责快速提案。它们与目标模型如何配合、接受多少候选以及怎样处理连续未命中,都会影响实际速度,不能只看理论加速比。
对哪些用户更有用
对在线推理服务,最直接的变化是单位时间可处理更多请求,或在延迟目标不变时扩大承载空间。但公开结果来自 Hy3-A21B,迁移到其他规模、架构、量化方式和硬件后,结果仍需重新测量,不能直接照搬倍数。
对开发者而言,AngelSpec 的价值在于同时涉及训练与部署。团队不仅要比较 DFly 和 DFlash,还要检查显存占用、草稿模型成本、请求长度、批处理策略与输出稳定性,推理加速不是接入一个开关就结束。
对内容创作者和普通用户,这类工作不会立刻改变产品界面,却可能改善长文本生成、代码补全和连续对话的响应体验。不过,模型知识、回答质量与上下文能力仍由目标模型决定,投机解码主要优化生成过程。
中文用户应该关注什么
中文用户可优先关注三点:官方是否补充清晰的许可证、硬件适配和复现脚本;社区能否在不同模型上验证收益;长文本与高并发场景是否稳定。源码和权重已经公开,接下来真正有说服力的,将是第三方复现与工程数据。
短期看,AngelSpec 更适合被当作推理效率工具箱来评估,而不是通用性能保证。若后续出现更多模型、部署平台与兼容性支持,投机解码有机会从少数团队的自建优化,逐渐变成大模型服务的常见组件。
同主题阅读路径
查看「模型发布」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具