纳德拉抛"反向信息悖论":企业用AI花钱,自己的知识也在免费流失
微软CEO纳德拉提出"反向信息悖论"概念:企业花钱调用AI,却在交互中把提示词、纠正反馈等专有知识交出去,信息不对称倒向AI供应商。他呼吁企业建立信任边界,掌控自有模型微调与组织记忆归属权。
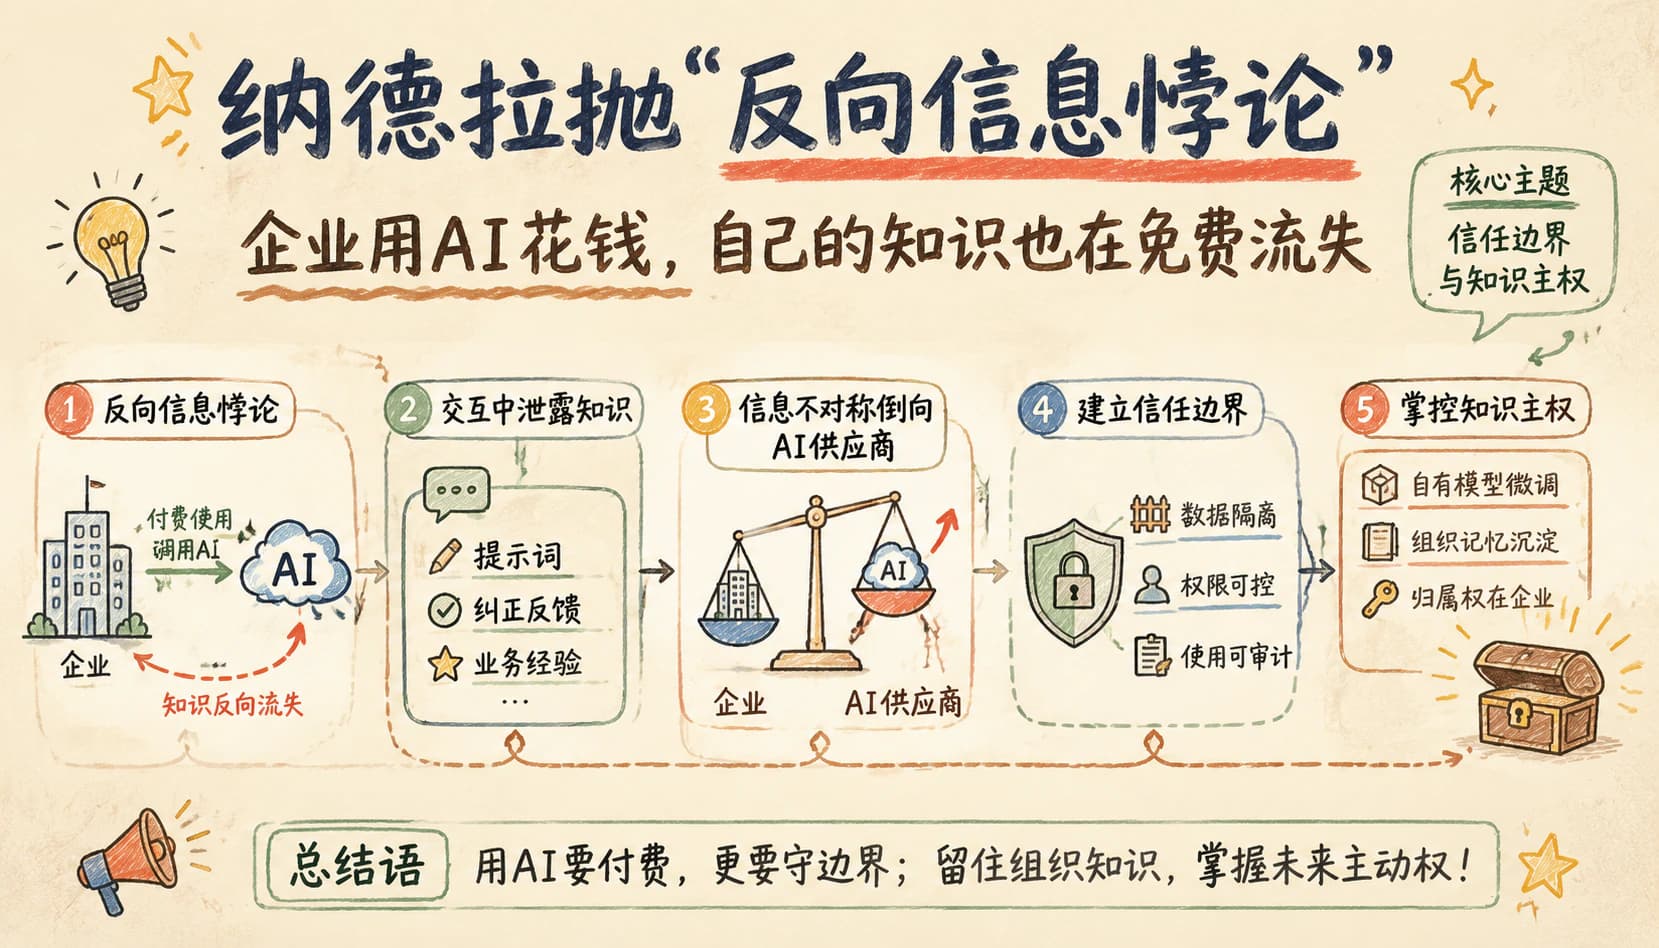
微软CEO萨提亚·纳德拉最近公开提出了一个新概念框架,叫做"反向信息悖论"。他用一句话点出了当下企业使用AI时的窘境:付费不等于拥有,反而可能越用越透明。
这个说法是对经典"信息悖论"的反向改写。传统讲法是,产品被体验越多,价值越低,例如香水广告、提前播出的电影。纳德拉把箭头调转:AI时代,用户付钱使用模型的过程,本身就在持续生产训练数据。
企业在不知不觉中交出什么
纳德拉举的例子并不抽象。一线员工在Copilot里写代码、在聊天助手里整理会议纪要,每一次提示词、每一次工具调用、每一次人工纠正,都是针对自家业务的一次微调数据集。这些数据不会只留在内存里,它们会进入模型的学习管线。
一开始单次贡献很小,但放到一年、三年里看,企业的工作流、文档结构、客户语境会越描越清楚。买家用得越依赖,自己的判断痕迹就越容易被学走,最终形成信息不对称持续向AI卖家倾斜的局面。
信任边界到底划在哪里
纳德拉给出的对策是一组具体动作,不是口号。企业需要拥有私有评估集、组织记忆的所有权、适配权重的归属,并有权使用模型输出来微调或训练自有模型。落到纸面上,就是合同条款和后台控制台里的具体选项。
这一主张直接挑战了目前主流云厂商的默认条款。很多商用大模型服务的默认设置,仍然把训练用数据归属、数据保留期、能否退出训练这几个开关藏在设置深处。而企业的法务和采购,在签合同前往往没问清楚。
对中文使用者意味着什么
国内企业用户和海外用户面对的结构性问题一致,但落点不同。用海外模型API的团队,要重点看日志保留时长、是否提供opt-out训练、数据是否进入任何模型迭代;用国内模型API的团队,则要逐字对照用户协议里关于数据归属和二次训练权的条款。
对个人开发者和内容创作者来说,这条提醒同样适用:核心业务判断、私域客户素材、能复制的工作流,别随手放进公共模型。它们可能比你想象的更容易被沉淀、被复用。
接下来值得观察的几件事
三件事值得持续跟踪。一是主流AI平台是否会跟随纳德拉的提法,推出对外可见的"数据使用面板";二是开源模型在数据归属上的差异化卖点会不会被市场放大;三是监管层是否会对"未经同意即用于训练"的边界给出更明确的口径。
这不是一篇警报,但可以视为一个节奏提示:在AI的买卖关系里,付费只能买到使用权,数据归属和训练控制权的谈判,会从2025年开始更频繁地出现在企业CIO和采购清单上。
同主题阅读路径
查看「模型发布」栏目读完文章后,如果你想继续筛选 AI 工具,可以从真实使用场景开始做横向比较。
查看 AI 工具